
PEFT documentation
BOFT
BOFT
Orthogonal Butterfly (BOFT), temel modellerin ince ayarı için tasarlanmış genel bir yöntemdir. Cooley-Tukey hızlı Fourier dönüşümünden ilham alarak ince ayar paradigminin — Orthogonal Finetuning (OFT) — parametre verimliliğini artırır; büyük görünümlü dönüştürücüler, büyük dil modelleri ve metinden görüntüye difüzyon modelleri dahil olmak üzere farklı temel modellerin ince ayarında olumlu sonuçlar gösterir.
Makalenin özeti şudur:
Büyük temel modeller giderek yaygınlaşırken, bunları sıfırdan eğitmek son derece maliyetlidir. Bu nedenle, bu güçlü modelleri aşağı akış görevlerine verimli bir şekilde uyarlamak giderek daha önemli hale gelmektedir. Bu makalede, aşağı akış görevi uyarlama için ilkesel bir ince ayar paradigması olan Ortogonal İnce Ayar (OFT) üzerine çalışıyoruz. İyi bir genellenebilirlik göstermesine rağmen, OFT, ortogonal matrislerin yüksek boyutluluğu nedeniyle hâlâ oldukça büyük sayıda eğitilebilir parametre kullanmaktadır. Bunu ele almak için, OFT'yi bir bilgi iletimi perspektifinden incelemeye başlıyor ve daha iyi parametre verimliliği sağlayan birkaç temel gerekliliği belirliyoruz. Cooley-Tukey hızlı Fourier dönüşümü algoritmasının verimli bilgi iletimini nasıl mümkün kıldığından ilham alarak, kelebek yapıları kullanan verimli bir ortogonal parametrelendirme öneriyoruz. Bu parametrelendirmeyi OFT'ye uygulayarak, Orthogonal Butterfly (BOFT) olarak adlandırılan yeni bir parametre-verimli ince ayar yöntemi oluşturuyoruz. OFT'yi özel bir durum olarak kapsayarak, BOFT genel bir ortogonal ince ayar çerçevesi sunuyor. Son olarak, büyük görünümlü dönüştürücülerin, büyük dil modellerinin ve metinden görüntüye difüzyon modellerinin görünümlü ve dil alanındaki çeşitli aşağı akış görevlerine uyarlanmasına yönelik kapsamlı bir ampirik çalışma yürütüyoruz.
BOFT, standart OFT'ye kıyasla çok daha parametre verimli olmasının yanı sıra, önceden eğitilmiş bir modelin üretken yeteneklerini korumaya odaklanır. OFT gibi BOFT de, önceden eğitilmiş ağırlık matrisine ortogonal bir dönüşüm uygulayarak bir katmandaki tüm çiftli nöronlar arasındaki aynı kosinüs benzerliğini (hiperküresel enerji) korur ve bu sayede nöronlar arasındaki anlamsal ilişkilerin korunmasını sağlar.
Blok köşegenli ortogonal bir matris kullanmak yerine BOFT, ortogonal dönüşümü sparse kelebek matrislerinin (ilk olarak Cooley–Tukey FFT'de tanıtılan) bir çarpımı olarak faktörize eder. OFT'nin, girdileri yalnızca her blok içinde karıştıran blok köşegenli dönmelerinin aksine, kelebek yapısı her girdinin her çıktıyı etkileyebileceğini garanti eder ve yalnızca O(d log d) parametreyle yoğun bir bağlantı oluşturur. Bu faktörizasyon, OFT'ye kıyasla parametre sayısını (hesaplama süresinin pahasına) dramatik bir şekilde azaltırken ifade gücünü korur.
Uygulamada, BOFT her önceden eğitilmiş ağırlık matrisini kelebek yapılı ortogonal çarpanlardan oluşan bir diziyle çarparak verimli ve ifade gücü yüksek nöron rotasyonlarını mümkün kılar. Bu durum, BOFT'yu kontrollü üretim ve önceden eğitilmiş modelin konu temsilini korumanın kritik olduğu görevler için uygun hale getirirken, aynı zamanda daha düşük bellek ve hesaplama maliyetiyle daha büyük modellere ölçeklenmesini sağlar.
BOFT, bir sinir ağındaki ağırlık matrislerinin herhangi bir alt kümesine uygulanarak eğitilebilir parametre sayısını azaltmak için kullanılabilir. BOFT parametrelerinin enjekte edileceği hedef katmanlar verildiğinde, eğitilebilir parametre sayısı, ağırlık matrislerinin boyutuna göre belirlenebilir.
Karma performans değerlendirmesi genel bakış
BOFT ağırlıklarını temel modele birleştirin
LoRA'ya benzer şekilde, BOFT tarafından öğrenilen ağırlıklar, [~BOFTModel.merge_and_unload() işlevi kullanılarak önceden eğitilmiş ağırlık matrislerine entegre edilebilir. Bu işlev, adaptör ağırlıklarını temel modelle birleştirir ve bu sayede yeni birleştirilmiş modelin bağımsız bir model olarak etkin bir şekilde kullanılmasını sağlar.
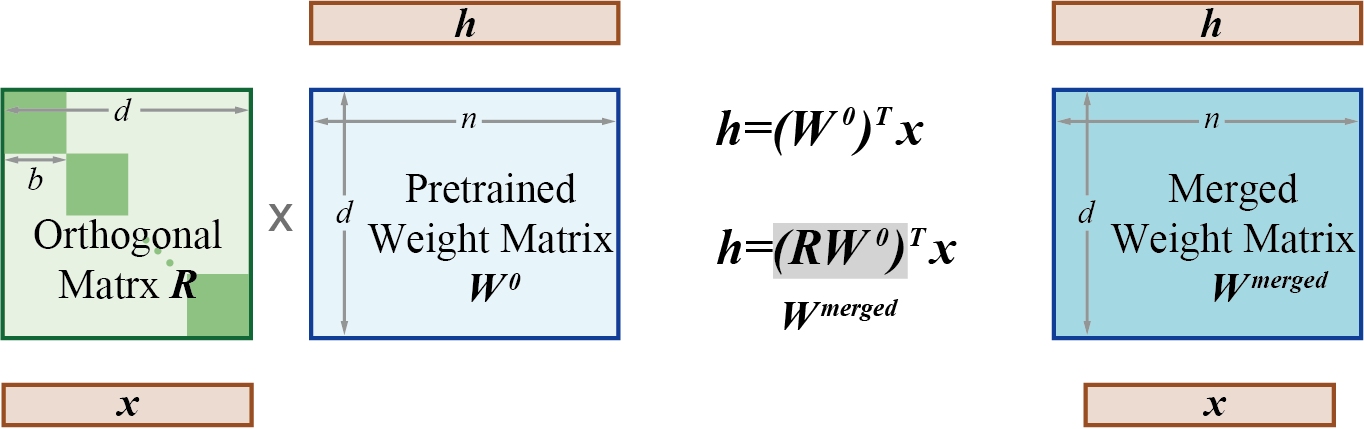
Bu, eğitim sırasında ortogonal ağırlık matrisinin (yukarıdaki şemadaki R) ve önceden eğitilmiş ağırlık matrislerinin ayrı olması nedeniyle işe yarar. Ancak eğitim tamamlandığında, bu ağırlıklar aslında eşdeğer yeni bir ağırlık matrisine birleştirilebilir (çarptırılabilir).
BOFT Örnek Kullanım
BOFT yönteminin çeşitli aşağı akış görevlerine uygulanmasına dair bir örnek için lütfen aşağıdaki kılavuzlara başvurun:
BOFT ile bir modelin nasıl ince ayar yapılacağına dair aşağıdaki adım adım kılavuzlara göz atın:
Görsel sınıflandırma görevi için DinoV2 modeli için BOFT yapılandırması şu şekilde başlatılabilir:
import transformers
from transformers import AutoModelForSeq2SeqLM, BOFTConfig
from peft import BOFTConfig, get_peft_model

config = BOFTConfig(
    boft_block_size=4,
    boft_n_butterfly_factor=2,
    target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
    boft_dropout=0.1,
    bias="boft_only",
    modules_to_save=["classifier"],
)

model = transformers.Dinov2ForImageClassification.from_pretrained(
    "facebook/dinov2-large",
    num_labels=100,
)

boft_model = get_peft_model(model, config)
API
BOFTConfig
sınıf peft.BOFTConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falseboft_block_size: int = 4boft_block_num: int = 0boft_n_butterfly_factor: int = 1target_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneboft_dropout: float = 0.0fan_in_fan_out: bool = Falsebias: str = 'none'modules_to_save: Optional[list[str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = None )
Parametreler
- boft_block_size (
int) — Farklı katmanlar boyunca BOFT matris bloğu boyutu,intolarak ifade edilir. Daha büyük blok boyutları, daha fazla eğitilebilir parametreye sahip daha yoğun güncelleme matrisleri sonuçlanır.boft_block_sizedeğerini, katmanların girdi boyutuna (in_features) bölünebilir olacak şekilde seçin, örneğin 4, 8, 16. Ayrıca, katmanın girdi boyutuna eşit olması gerektiği içinboft_block_sizeveyaboft_block_numdeğerlerinden yalnızca birini belirtin; ikisini aynı anda belirtmeyin veya ikisini de 0 olarak bırakmayın, çünküboft_block_sizexboft_block_numkatmanın girdi boyutuna eşit olmalıdır. - boft_block_num (
int) — Enjekte edilen katman başına BOFT bloğu sayısı. Daha büyükboft_block_numdeğerleri, daha az eğitilebilir parametreye sahip daha seyreltik güncelleme matrisleri sonuçlanır. Not,boft_block_numdeğerini, katmanların girdi boyutuna (in_features) bölünebilir olacak şekilde seçin, örneğin 4, 8, 16.boft_block_sizeveyaboft_block_numdeğerlerinden yalnızca birini belirtin; ikisini aynı anda belirtmeyin veya ikisini de 0 olarak bırakmayın, çünküboft_block_sizexboft_block_numkatmanın girdi boyutuna eşit olmalıdır. - boft_n_butterfly_factor (
int) — Farklı katmanlar boyunca kelebek faktörlerinin sayısı.boft_n_butterfly_factor=1için BOFT, standart OFT ile aynıdır;boft_n_butterfly_factor=2için OFT'nin etkin blok boyutu iki katına çıkar ve blok sayısı yarıya iner. - target_modules (
Union[List[str],str]) — Adaptörün uygulanacağı modüllerin adları. - exclude_modules (
Optional[Union[List[str], str]]) — Uyarlamanın (adapter) uygulanmaması istenen modüllerin adları. Bir dize geçirildiğinde, bir regex eşleşmesi yapılır. Bir dize listesi geçirildiğinde, tam bir eşleşme yapılır veya modül adının, geçirilen dizelerden herhangi biriyle sonlanıp sonlanmadığı kontrol edilir. - boft_dropout (
float) — LoRA'daki dropout katmanına benzer şekilde, eğitim sırasında OFT bloklarını kimlik olarak ayarlayarak çarpımsal dropout olasılığı. - fan_in_fan_out (
bool) — Değiştirilecek katman ağırlıkları (fan_in, fan_out) biçiminde saklıyorsa bunu True olarak ayarlayın. Örneğin, gpt-2 ağırlıkları (fan_in, fan_out) biçiminde saklayanConv1Dkullanır ve bu nedenle bu değerTrueolarak ayarlanmalıdır. - bias (
str) — Bias type for BOFT. Can be ‘none’, ‘all’ or ‘boft_only’. If ‘all’ or ‘boft_only’, the corresponding biases will be updated during training. Be aware that this means that, even when disabling the adapters, the model will not produce the same output as the base model would have without adaptation. - modules_to_save (
List[str]) — BOFT katmanları dışında, eğitilebilir olarak ayarlanacak ve nihai checkpoint'te kaydedilecek modüllerin listesi - layers_to_transform (
Union[List[int],int]) — Dönüştürülecek katman indeksleri. Bu argüman belirtilirse, BOFT dönüşümleri bu listede belirtilen katman indekslerine uygulanır. Tek bir tamsayı geçirilirse, BOFT dönüşümleri bu indeksteki katmana uygulanır. - layers_pattern (
Optional[Union[List[str], str]]) — Katman desen adı, yalnızcalayers_to_transformNone'den farklıysa ve katman deseni ortak katman desenlerinde yer almıyorsa kullanılır. Bu, genellikle'layers'veya'h'olarak adlandırılan modelinnn.ModuleList'ini hedeflemelidir.
Bu, bir BOFTModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır.
BOFTModel
sınıf peft.BOFTModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Parametreler
- model (transformers.PreTrainedModel) — Uyarlanacak model.
- config (BOFTConfig) — BOFT modelinin yapılandırması.
- adapter_name (
str) — Adaptörün adı, varsayılan olarak"default"'tır. - low_cpu_mem_usage (
bool,optional, defaults toFalse) — Meta cihazda boş adaptör ağırlıkları oluşturur. Yükleme sürecini hızlandırmak için faydalıdır.
Dönüş değeri
torch.nn.Module
BOFT modeli.
Önceden eğitilmiş bir transformers modelinden BOFT ve OFT modeli oluşturur. Makale: https://huggingface.co/papers/2311.06243 https://huggingface.co/papers/2306.07280
Örnek:
>>> import transformers
>>> from peft import BOFTConfig, get_peft_model

>>> config = BOFTConfig(
...     boft_block_size=8,
...     boft_n_butterfly_factor=1,
...     target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
...     boft_dropout=0.1,
...     bias="boft_only",
...     modules_to_save=["classifier"],
... )

>>> model = transformers.Dinov2ForImageClassification.from_pretrained(
...     "facebook/dinov2-large",
...     num_labels=100,
... )
>>> boft_model = get_peft_model(model, config)Öznitelikler:
- model (transformers.PreTrainedModel) — Uyarlanacak model.
- peft_config (BOFTConfig): BOFT modelinin yapılandırması.