
PEFT documentation
OFT
OFT
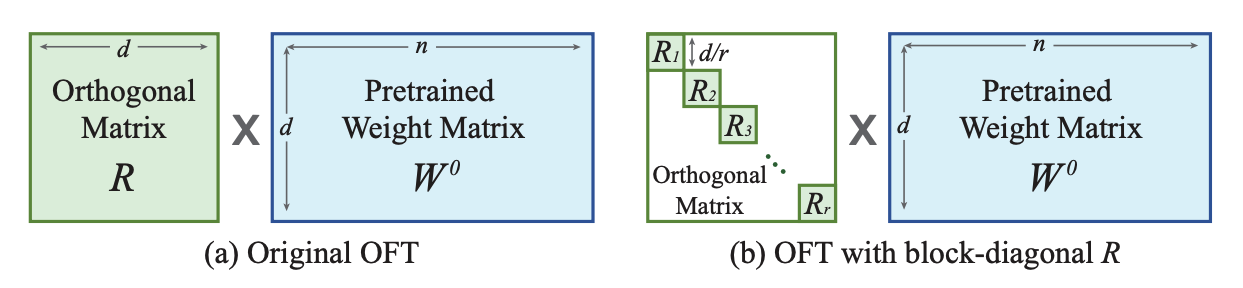
Orthogonal Finetuning (OFT) e OFTv2 são um método desenvolvido para adaptar modelos de difusão de texto para imagem. Ele funciona reparametrizando as matrizes de pesos pré-treinadas com sua matriz ortogonal para preservar as informações do modelo pré-treinado. Para reduzir o número de parâmetros, o OFT introduz uma estrutura em bloco diagonal na matriz ortogonal. O método foca principalmente em preservar o desempenho generativo de um modelo pré-treinado no modelo ajustado. Ele tenta manter a mesma similaridade cosseno (energia hipersférica) entre todos os pares de neurônios em uma camada, pois isso captura melhor as informações semânticas entre os neurônios. Isso significa que o OFT é mais capaz de preservar o sujeito e é melhor para geração controlável (similar ao ControlNet).
O resumo do artigo é:
Os grandes modelos de difusão de texto para imagem possuem capacidades impressionantes na geração de imagens fotorrealistas a partir de prompts de texto. Como guiar ou controlar efetivamente esses modelos poderosos para executar diferentes tarefas downstream torna-se um problema aberto importante. Para enfrentar esse desafio, introduzimos um método de finetuning fundamentado — Orthogonal Finetuning (OFT), para adaptar modelos de difusão de texto para imagem a tarefas downstream. Diferentemente dos métodos existentes, o OFT pode preservar comprovadamente a energia hipersférica, que caracteriza a relação par a par entre neurônios na hipersfera unitária. Descobrimos que essa propriedade é crucial para preservar a capacidade de geração semântica dos modelos de difusão de texto para imagem. Para melhorar a estabilidade do finetuning, propomos ainda o Constrained Orthogonal Finetuning (COFT), que impõe uma restrição adicional de raio à hipersfera. Especificamente, consideramos duas tarefas importantes de finetuning de texto para imagem: geração dirigida por sujeito, cujo objetivo é gerar imagens específicas de um sujeito dado algumas imagens desse sujeito e um prompt de texto, e geração controlável, cujo objetivo é permitir que o modelo receba sinais de controle adicionais. Demonstramos empiricamente que nosso framework OFT supera os métodos existentes em qualidade de geração e velocidade de convergência.
OFT preserva a energia hipersférica ao aprender uma transformação ortogonal para os neurônios, mantendo a similaridade de cosseno entre eles inalterada, o que pode levar a menos esquecimento do conhecimento previamente aprendido. Na prática, isso significa calcular o produto matricial de uma matriz ortogonal com a matriz de pesos pré-treinada. No entanto, para ser eficiente em termos de parâmetros, a matriz ortogonal é representada como uma matriz em bloco diagonal com blocos de posto r. Enquanto o LoRA reduz o número de parâmetros treináveis com estruturas de baixo posto, o OFT reduz o número de parâmetros treináveis com uma estrutura de matriz em bloco diagonal esparsa.
Visão geral do benchmark
Mesclar os pesos do OFT no modelo base
Assim como no LoRA, os pesos aprendidos pelo OFT podem ser integrados às matrizes de pesos pré-treinadas usando a função [~OFTModel.merge_and_unload(). Essa função mescla os pesos do adaptador com o modelo base, o que permite usar o modelo recém-mesclado de forma eficaz como um modelo independente.
Exemplo de uso do OFT
Para usar OFT para ajuste fino quantizado com TRL para ajuste fino SFT, PPO ou DPO, siga o seguinte esquema:
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
from trl import SFTTrainer
from peft import OFTConfig

if use_quantization:
    bnb_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=torch.bfloat16,
        bnb_4bit_use_double_quant=True,
        bnb_4bit_quant_storage=torch.bfloat16,
    )

model = AutoModelForCausalLM.from_pretrained(
    "model_name",
    quantization_config=bnb_config
)
tokenizer = AutoTokenizer.from_pretrained("model_name")

# Configure OFT
peft_config = OFTConfig(
    oft_block_size=32,
    use_cayley_neumann=True,
    target_modules="all-linear",
    bias="none",
    task_type="CAUSAL_LM"
)

trainer = SFTTrainer(
    model=model,
    train_dataset=ds['train'],
    peft_config=peft_config,
    processing_class=tokenizer,
    args=training_arguments,
    data_collator=collator,
)

trainer.train()
API
OFTConfig
classe peft.OFTConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falser: int = 0oft_block_size: int = 32module_dropout: float = 0.0target_modules: Optional[Union[list[str], str]] = Nonefan_in_fan_out: bool = Falsebias: Literal['none', 'all', 'oft_only'] = 'none'exclude_modules: Optional[Union[list[str], str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = Nonemodules_to_save: Optional[list[str]] = Nonecoft: bool = Falseeps: float = 6e-05block_share: bool = Falseuse_cayley_neumann: bool = Truenum_cayley_neumann_terms: int = 5 )
Parâmetros
- r (
int) — Rank do OFT, número de blocos OFT por camada injetada. Umrmaior resulta em matrizes de atualização mais esparsas com menos parâmetros treináveis. Você pode especificar apenasrouoft_block_size, mas não ambos simultaneamente, poisr×oft_block_size= dimensão da camada. Para simplificar, permitimos que você especifiquerouoft_block_sizee inferimos o outro. O padrão ér = 0; recomenda-se que o usuário defina ooft_block_sizeem vez disso, para maior clareza. - oft_block_size (
int) — Tamanho do bloco OFT entre as diferentes camadas. Umoft_block_sizemaior resulta em matrizes de atualização mais densas, com mais parâmetros treináveis. Escolha umoft_block_sizedivisível pela dimensão de entrada da camada (in_features), por exemplo, 4, 8, 16. Você pode especificar apenasrouoft_block_size, mas não ambos simultaneamente, poisr×oft_block_size= dimensão da camada. Para simplificar, permitimos que você especifiquerouoft_block_sizee inferimos o outro. O padrão é definido comooft_block_size = 32. - use_cayley_neumann (bool) — Especifica se deve ser usada a parametrização de Cayley-Neumann (eficiente, porém aproximada) ou a parametrização de Cayley padrão (exata, porém computacionalmente cara devido à inversão de matriz). Recomendamos definir como
Truepara melhor eficiência, mas o desempenho pode ser ligeiramente pior devido ao erro de aproximação. Teste ambas as configurações (TrueeFalse) conforme suas necessidades. O padrão éFalse. - module_dropout (
float) — A probabilidade de dropout multiplicativo, definida ao configurar os blocos OFT como identidade durante o treinamento, semelhante à camada de dropout no LoRA. - target_modules (
Optional[Union[list[str], str]]) — Os nomes dos módulos aos quais o adaptador será aplicado. Se especificado, apenas os módulos com os nomes especificados serão substituídos. Ao passar uma string, uma correspondência por expressão regular será realizada. Ao passar uma lista de strings, uma correspondência exata será realizada ou será verificado se o nome do módulo termina com qualquer uma das strings passadas. Se especificado como ‘all-linear’, todos os módulos lineares serão escolhidos, excluindo a camada de saída. Se não especificado, os módulos serão escolhidos de acordo com a arquitetura do modelo. Se a arquitetura não for conhecida, um erro será lançado — nesse caso, você deve especificar os módulos de destino manualmente. - fan_in_fan_out (
bool) — Defina como True se a camada a ser substituída armazena pesos como (fan_in, fan_out). - bias (
str) — Tipo de viés para OFT. Pode ser ‘none’, ‘all’ ou ‘oft_only’. Se for ‘all’ ou ‘oft_only’, os vieses correspondentes serão atualizados durante o treinamento. Tenha em mente que isso significa que, mesmo ao desativar os adaptadores, o modelo não produzirá a mesma saída que o modelo base teria sem adaptação. - exclude_modules (
Optional[Union[List[str], str]]) — Os nomes dos módulos para os quais o adaptador não deve ser aplicado. Ao passar uma string, será realizada uma correspondência por expressão regular. Ao passar uma lista de strings, será realizada uma correspondência exata ou será verificado se o nome do módulo termina com qualquer uma das strings passadas. - init_weights (
bool) — Se deve executar a inicialização dos pesos do OFT. - layers_to_transform (
Union[List[int], int]) — Os índices das camadas a serem transformadas. Se uma lista de inteiros for passada, o adaptador será aplicado aos índices das camadas especificados nessa lista. Se um único inteiro for passado, as transformações serão aplicadas à camada nesse índice. - layers_pattern (
Optional[Union[List[str], str]]) — O nome do padrão de camadas, usado apenas selayers_to_transformfor diferente deNone. Isso deve apontar para onn.ModuleListdo modelo, que frequentemente é chamado de'layers'ou'h'. - modules_to_save (
List[str]) — Lista de módulos, além das camadas de adaptador, que devem ser configurados como treináveis e salvos no checkpoint final. - coft (
bool) — Se deve usar a variante restrita do OFT ou não, desativado por padrão. - eps (
float) — A intensidade de controle do COFT. A liberdade de rotação. Tem efeito apenas secoftestiver definido como True. - block_share (
bool) — Se os parâmetros do OFT devem ser compartilhados entre os blocos ou não. O valor padrão éFalse.
Esta é a classe de configuração para armazenar a configuração de um OFTModel.
check_kwargs
< source >( **kwargs )
Verifique se os kwargs são válidos para a configuração.
OFTModel
classe peft.OFTModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Parâmetros
- model (
torch.nn.Module) — O modelo ao qual as camadas do adaptador tuner serão anexadas. - config (OFTConfig) — A configuração do modelo OFT.
- adapter_name (
str) — O nome do adaptador, padrão é"default". - low_cpu_mem_usage (
bool,optional, defaults toFalse) — Cria pesos de adaptador vazios no dispositivo meta. Útil para acelerar o processo de carregamento.
Retorna
torch.nn.Module
O modelo OFT.
Cria um modelo Orthogonal Finetuning a partir de um modelo pré-treinado. O método é descrito em https://huggingface.co/papers/2306.07280
Exemplo:
>>> from diffusers import StableDiffusionPipeline
>>> from peft import OFTModel, OFTConfig

>>> config_te = OFTConfig(
...     r=8,
...     target_modules=["k_proj", "q_proj", "v_proj", "out_proj", "fc1", "fc2"],
...     module_dropout=0.0,
...     init_weights=True,
... )
>>> config_unet = OFTConfig(
...     r=8,
...     target_modules=[
...         "proj_in",
...         "proj_out",
...         "to_k",
...         "to_q",
...         "to_v",
...         "to_out.0",
...         "ff.net.0.proj",
...         "ff.net.2",
...     ],
...     module_dropout=0.0,
...     init_weights=True,
... )

>>> model = StableDiffusionPipeline.from_pretrained("runwayml/stable-diffusion-v1-5")
>>> model.text_encoder = OFTModel(model.text_encoder, config_te, "default")
>>> model.unet = OFTModel(model.unet, config_unet, "default")Atributos:
- model (
~torch.nn.Module) — O modelo a ser adaptado. - peft_config (OFTConfig): A configuração do modelo OFT.