
LeRobot documentation
LIBERO
LIBERO
The commands below run the simulator locally. To keep its dependencies away from your policy's, serve it instead with `lerobot-env-server --config_path=docker/sim/configs/libero.yaml --sim.task=--docker=true`, where ` ` is the command's `--env.task`, and add `--env.server.endpoint=tcp/127.0.0.1:7448` to the command. A server runs the task it was started with (see [Simulation: local or served](./simulation)).
LIBERO é um benchmark projetado para estudar lifelong robot learning — a ideia de que robôs precisam continuar aprendendo e se adaptando com seus usuários ao longo do tempo, e não apenas serem pré-treinados uma única vez. Ele fornece um conjunto de tarefas de manipulação padronizadas que focam em knowledge transfer: o quão bem um robô consegue aplicar o que já aprendeu a novas situações. Ao avaliar no LIBERO, diferentes algoritmos podem ser comparados de forma justa e pesquisadores podem construir sobre o trabalho uns dos outros.
- Artigo: Benchmarking Knowledge Transfer for Lifelong Robot Learning
- GitHub: Lifelong-Robot-Learning/LIBERO
- Site do projeto: libero-project.github.io
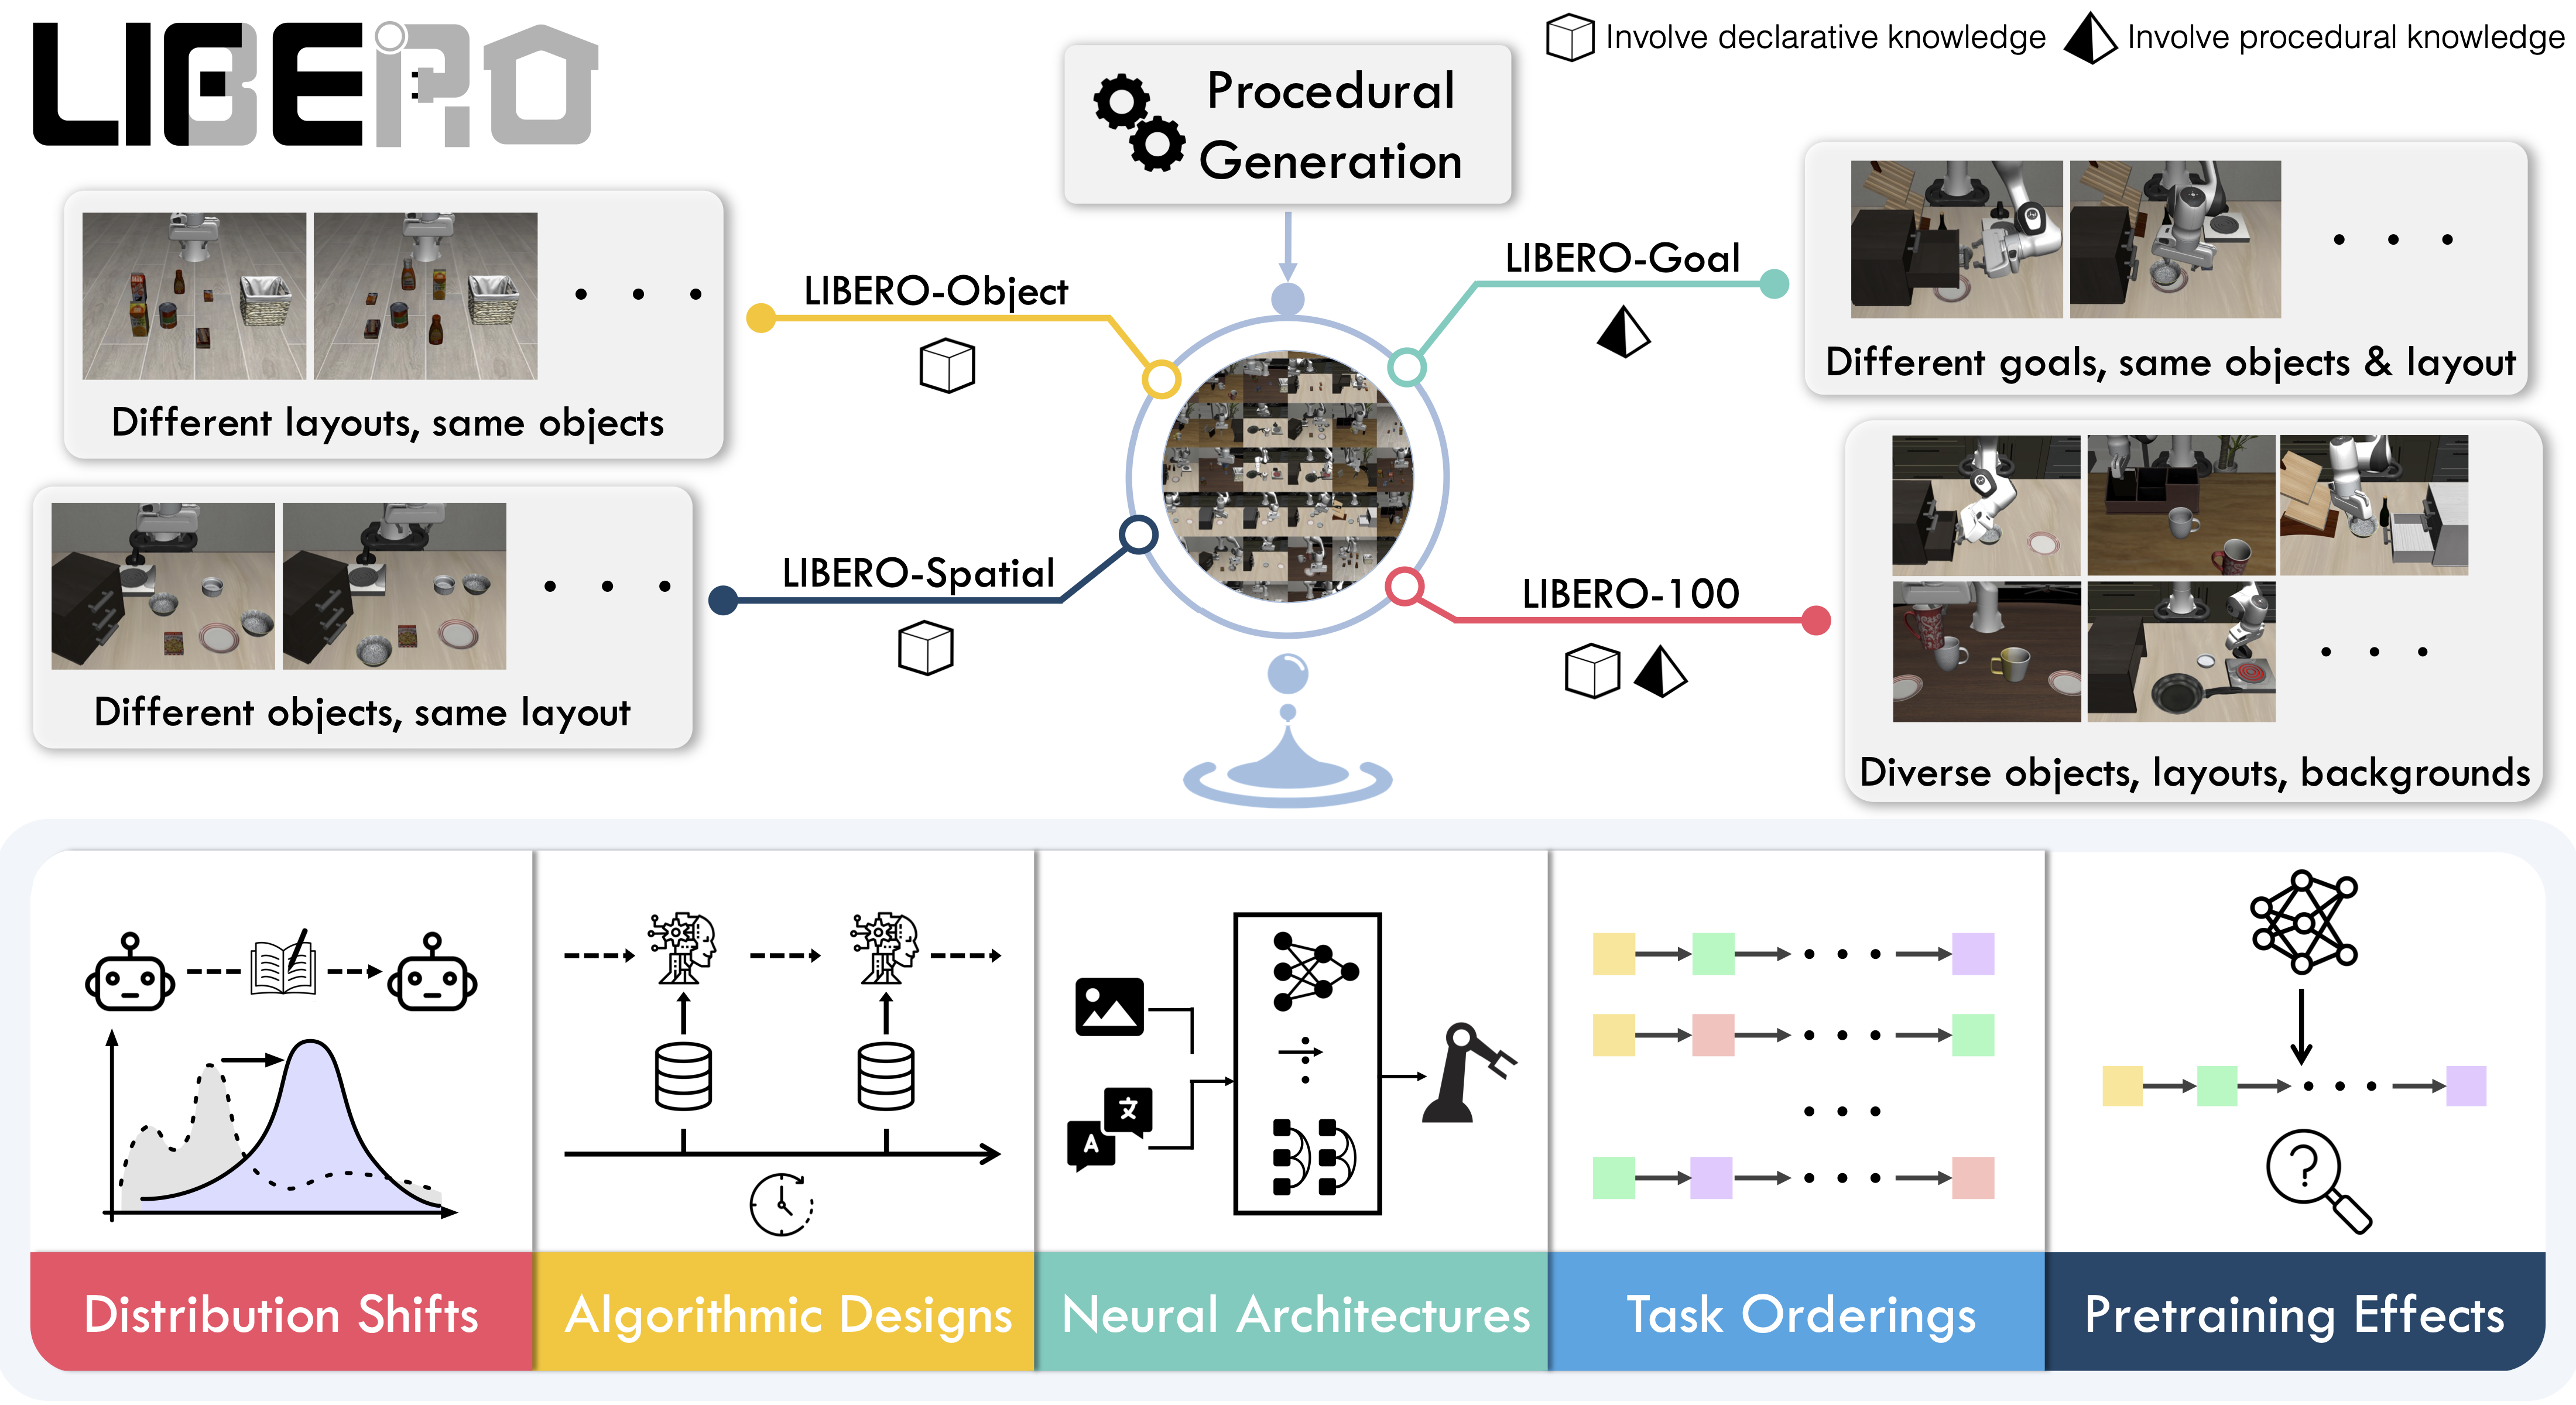
Tarefas disponíveis
LIBERO inclui cinco suítes de tarefas cobrindo 130 tarefas, variando de manipulações simples de objetos a cenários complexos de múltiplas etapas:
| Suite | Nome da CLI | Tarefas | Descrição |
|---|---|---|---|
| LIBERO-Spatial | libero_spatial | 10 | Tarefas que exigem raciocínio sobre relações espaciais |
| LIBERO-Object | libero_object | 10 | Tarefas centradas na manipulação de diferentes objetos |
| LIBERO-Goal | libero_goal | 10 | Tarefas condicionadas a objetivos com alvos em mudança |
| LIBERO-90 | libero_90 | 90 | Tarefas de curto horizonte da coleção LIBERO-100 |
| LIBERO-Long | libero_10 | 10 | Tarefas de longo horizonte da coleção LIBERO-100 |
Instalação
Após seguir as instruções de instalação do LeRobot:
pip install -e ".[libero]"LIBERO requires Linux (`sys_platform == 'linux'`). LeRobot uses MuJoCo for simulation — set the rendering backend before training or evaluation:export MUJOCO_GL=egl # for headless servers (HPC, cloud)
Avaliação
Avaliação local padrão
Avalie nos quatro conjuntos padrão (10 episódios por tarefa):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
Avaliação em um único conjunto
Avalie em um único conjunto do LIBERO:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object \
  --eval.batch_size=2 \
--eval.n_episodes=3--env.taskseleciona a suíte (libero_object,libero_spatial, etc.).--env.task_idsrestringe a índices específicos de tarefas ([0],[1,2,3], etc.). Omita para executar todas as tarefas da suíte.--eval.batch_sizecontrola quantos ambientes são executados em paralelo.--eval.n_episodesdefine quantos episódios serão executados por tarefa.
Avaliação multi-suite
Faça o benchmark de uma política em vários conjuntos de uma só vez passando uma lista separada por vírgulas:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object,libero_spatial \
  --eval.batch_size=1 \
  --eval.n_episodes=2
Modo de controle
O LIBERO suporta dois modos de controle — relative (padrão) e absolute. Diferentes checkpoints de VLA são treinados com diferentes parametrizações de ação, portanto, certifique-se de que o modo corresponda à sua política:
--env.control_mode=relative # or "absolute"Redefinir desempenho
Por padrão, o LeRobot preserva o comportamento de hard-reset do LIBERO. Com os estados iniciais fixos habilitados, você pode optar por soft resets para evitar a reconstrução do modelo do simulador e do renderer a cada episódio:
--env.init_states=true --env.hard_reset=falseSoft resets são mais rápidos, mas não são idênticos bit a bit aos hard resets após as etapas de estabilização do ambiente, portanto, as observações da câmera e os resultados da política podem diferir ligeiramente. Use hard resets ao reproduzir resultados de benchmarks.
Entradas e saídas da política
Observações:
observation.state— recursos proprioceptivos de 8 dimensões (posição do eef, orientação axis-angle, qpos do garra)observation.images.image— visão da câmera principal (agentview_image), HWC uint8observation.images.image2— visão da câmera do pulso (robot0_eye_in_hand_image), HWC uint8
LeRobot enforces the `.images.*` prefix for visual features. Ensure your policy config `input_features` use the same naming keys, and that your dataset metadata keys follow this convention. If your data contains different keys, you must rename the observations to match what the policy expects, since naming keys are encoded inside the normalization statistics layer.
Ações:
- Controle contínuo em
Box(-1, 1, shape=(7,))— delta do efector final 6D + garra 1D
Episódios de avaliação recomendados
Para benchmarking reproduzível, use 10 episódios por tarefa em todos os quatro conjuntos padrão (Spatial, Object, Goal, Long). Isso resulta em 400 episódios no total e corresponde ao protocolo utilizado para os resultados publicados. As taxas de sucesso podem variar em alguns pontos percentuais entre as sementes de avaliação, portanto, recomendamos fazer a média sobre 3 sementes.
lerobot-eval relata um intervalo de Wilson de 95% (pc_success_ci95) ao lado de cada taxa de sucesso. Com 10 episódios, uma tarefa com pontuação de 9/10 tem um intervalo de aproximadamente 60% a 98%, e um total de suíte de 400 episódios em 80% tem um intervalo de aproximadamente 76% a 84%. Duas políticas cujos intervalos se sobrepõem em uma tarefa não foram demonstradas como diferentes nessa tarefa por aquela execução. O intervalo cobre quais episódios foram sorteados; ele não cobre a semente de treinamento da política, o que requer mais de uma execução de treinamento para ser medido.
To compare two policies on the same episodes, use the same `--seed`, keep `--env.init_states=true`, and run each task in a single batch (`--eval.batch_size` equal to episodes per task).
Treinamento
Conjunto de dados
Dois conjuntos de dados LIBERO pré-processados são totalmente compatíveis com LeRobot. Eles contêm as mesmas demonstrações com o mesmo esquema e diferem em como os quadros da câmera são armazenados:
| lerobot/libero | HuggingFaceVLA/libero | |
|---|---|---|
| episódios / quadros / tarefas | 1,693 / 273,465 / 40 | 1,693 / 273,465 / 40 |
| câmeras | 2× 256×256×3 | 2× 256×256×3 |
| dimensões de estado / ação | 8 / 7 | 8 / 7 |
| formato do dataset | v3.0 | v3.0 |
| codificação de câmera | Vídeo MP4 | PNG em parquet |
| tamanho do download | 1,9 GB | 69,9 GB |
| dependência extra | backend de vídeo (torchcodec ou pyav) | none |
Recomendamos lerobot/libero: download 37× menor com velocidade de carregamento equivalente (~330 amostras/s por worker). A re-codificação do vídeo é ligeiramente com perdas; use a variante baseada em imagens se não puder instalar um backend de decodificação de vídeo.
Para referência, o conjunto de dados original publicado pela Physical Intelligence:
Pin `--dataset.revision=` when reporting results — Hub datasets can be re-uploaded, and success rates are only comparable against the same data revision.
Exemplo de comando de treinamento
Treine o SmolVLA no dataset recomendado:
lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --dataset.repo_id=lerobot/libero \
  --dataset.video_backend=torchcodec \
  --output_dir=./outputs/libero_smolvla \
  --steps=100000 \
  --batch_size=64
Para compartilhar o resultado no Hub, substitua --policy.push_to_hub=false por --policy.repo_id=${HF_USER}/libero-smolvla. Avalie os checkpoints salvos com lerobot-eval conforme mostrado na seção Avaliação.
Reproduzindo resultados publicados
Reproduzimos os resultados do Pi0.5 no benchmark LIBERO. Utilizamos o modelo base LIBERO da Physical Intelligence (pi05_libero) e realizamos o finetuning por mais 6k passos em bfloat16, com batch size de 256 em 8 GPUs H100, usando o conjunto de dados LIBERO do HuggingFace.
O modelo ajustado: lerobot/pi05_libero_finetuned
Comando de avaliação
lerobot-eval \
  --output_dir=./eval_logs/ \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --policy.path=lerobot/pi05_libero_finetuned \
  --policy.n_action_steps=10 \
  --env.max_parallel_tasks=1
Definimos n_action_steps=10, em conformidade com a implementação original do OpenPI.
Resultados
| Model | LIBERO Spatial | Objeto LIBERO | Objetivo do LIBERO | LIBERO 10 | Média |
|---|---|---|---|---|---|
| Pi0.5 (LeRobot) | 97.0 | 99.0 | 98.0 | 96.0 | 97.5 |
Esses resultados são consistentes com os resultados originais relatados pela Physical Intelligence:
| Model | LIBERO Spatial | Objeto LIBERO | Objetivo do LIBERO | LIBERO 10 | Média |
|---|---|---|---|---|---|
| Pi0.5 (OpenPI) | 98.8 | 98.2 | 98.0 | 92.4 | 96.85 |