# X-CLIP
## Resumen
El modelo X-CLIP fue propuesto en [Expanding Language-Image Pretrained Models for General Video Recognition](https://huggingface.co/papers/2208.02816) por Bolin Ni, Houwen Peng, Minghao Chen, Songyang Zhang, Gaofeng Meng, Jianlong Fu, Shiming Xiang y Haibin Ling. X-CLIP es una extensión mínima de [CLIP](clip) para video. El modelo consta de un codificador de texto, un codificador visual entre fotogramas, un Transformer de integración multi-fotograma y un generador de prompts específico para video.
El resumen del artículo es el siguiente:
*El preentrenamiento contrastivo de lenguaje e imagen ha demostrado un gran éxito en el aprendizaje de representaciones conjuntas visuales y textuales a partir de datos a escala web, mostrando una notable capacidad de generalización "zero-shot" para diversas tareas de imagen. Sin embargo, cómo expandir eficazmente estos nuevos métodos de preentrenamiento de lenguaje e imagen al dominio del video sigue siendo un problema abierto. En este trabajo, presentamos un enfoque simple pero eficaz que adapta los modelos de lenguaje e imagen preentrenados directamente al reconocimiento de video, en lugar de preentrenar un nuevo modelo desde cero. Más concretamente, para capturar las dependencias de largo alcance de los fotogramas a lo largo de la dimensión temporal, proponemos un mecanismo de atención entre fotogramas que intercambia información explícitamente entre ellos. Este módulo es ligero y puede integrarse sin problemas en los modelos de lenguaje e imagen preentrenados. Además, proponemos un esquema de prompting específico para video, que aprovecha la información del contenido del video para generar prompts textuales discriminativos. Experimentos extensos demuestran que nuestro enfoque es eficaz y puede generalizarse a diferentes escenarios de reconocimiento de video. En particular, en configuraciones totalmente supervisadas, nuestro enfoque alcanza una precisión top-1 del 87,1 % en Kinectics-400, utilizando 12 veces menos FLOPs en comparación con Swin-L y ViViT-H. En experimentos zero-shot, nuestro enfoque supera a los métodos state-of-the-art actuales en +7,6 % y +14,9 % en términos de precisión top-1 bajo dos protocolos populares. En escenarios few-shot, nuestro enfoque supera a los mejores métodos anteriores en +32,1 % y +23,1 % cuando los datos etiquetados son extremadamente limitados.*
Consejos:
- El uso de X-CLIP es idéntico al de [CLIP](clip).
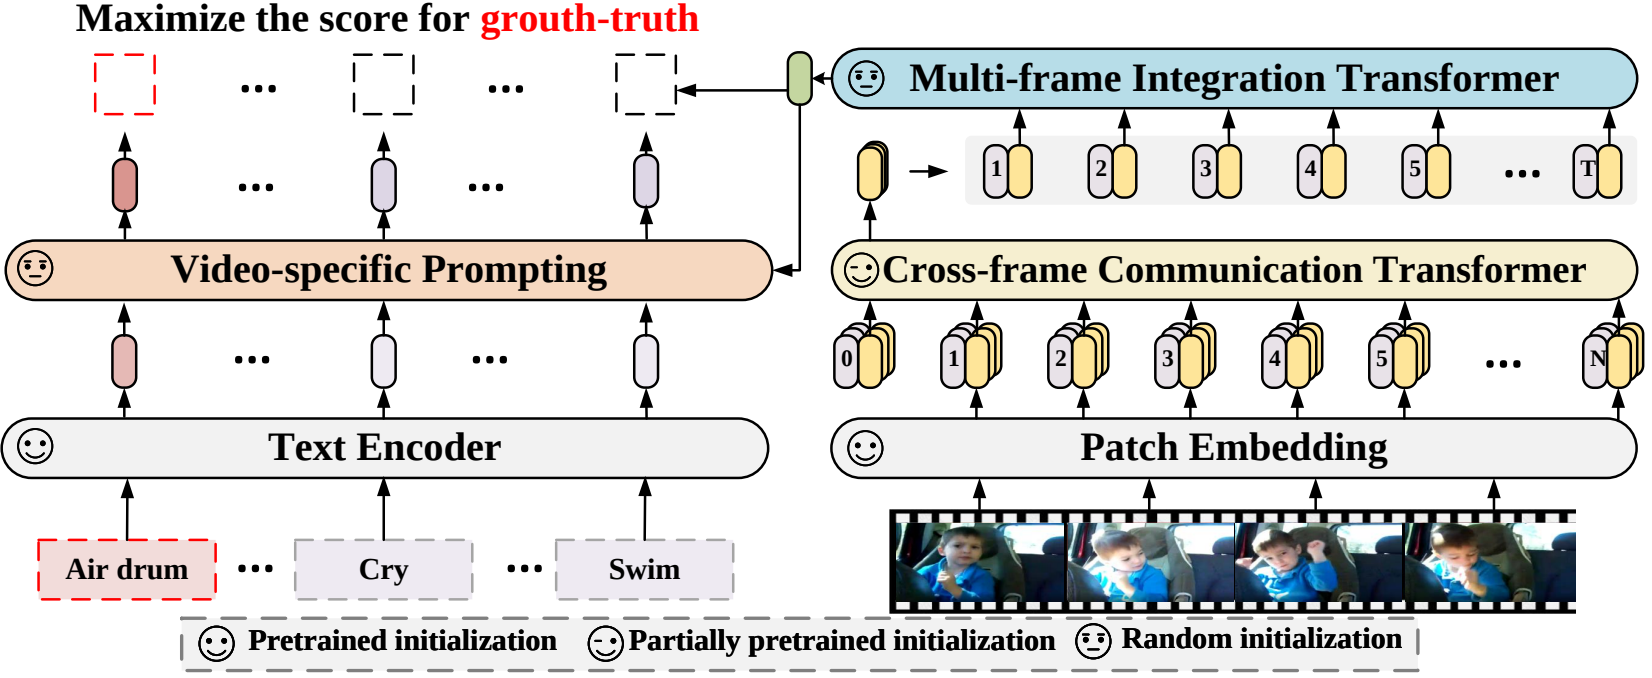 Arquitectura de X-CLIP. Tomada del artículo original.
Este modelo fue aportado por [nielsr](https://huggingface.co/nielsr). El código original se puede encontrar [aquí](https://github.com/microsoft/VideoX/tree/master/X-CLIP).
## Recursos
Una lista de recursos oficiales de Hugging Face y de la comunidad (indicados con 🌎) para ayudarte a empezar con X-CLIP.
- Los cuadernos de demostración de X-CLIP se pueden encontrar [aquí](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/X-CLIP).
Si te interesa enviar un recurso para que se incluya aquí, no dudes en abrir una Pull Request y lo revisaremos. Lo ideal es que el recurso demuestre algo nuevo en lugar de duplicar un recurso existente.
## XCLIPProcessor[[transformers.XCLIPProcessor]]
#### transformers.XCLIPProcessor[[transformers.XCLIPProcessor]]
```python
transformers.XCLIPProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/processing_x_clip.py#L23)
**Parámetros:**
image_processor (`image_processor_class`): el procesador de imágenes es un parámetro de entrada obligatorio.
tokenizer (`tokenizer_class`): El tokenizador es una entrada obligatoria.
Crea un XCLIPProcessor que encapsula un procesador de imágenes y un tokenizador en un único procesador.
[XCLIPProcessor](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPProcessor) ofrece todas las funcionalidades de `image_processor_class` y `tokenizer_class`. Consulte `~image_processor_class` y `~tokenizer_class` para obtener más información.
#### __llamada__[[transformers.XCLIPProcessor.__call__]]
```python
__call__(images = None, text = None, videos = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/processing_x_clip.py#L28)
## XCLIPConfig[[transformers.XCLIPConfig]]
#### transformers.XCLIPConfig[[transformers.XCLIPConfig]]
```python
transformers.XCLIPConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, projection_dim: int = 512, prompt_layers: int = 2, prompt_alpha: float = 0.1, prompt_hidden_act: str = 'quick_gelu', prompt_num_attention_heads: int = 8, prompt_attention_dropout: float | int = 0.0, prompt_projection_dropout: float | int = 0.0, logit_scale_init_value: float = 2.6592, initializer_factor: float = 1.0)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/configuration_x_clip.py#L119)
**Parámetros:**
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : El objeto de configuración o el diccionario del backbone de texto.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : El objeto de configuración o el diccionario del backbone de visión.
projection_dim (`int`, *opcional*, valor predeterminado `512`) : Dimensionalidad de las capas de proyección de texto y visión.
prompt_layers (`int`, *opcional*, valor predeterminado 2) : Número de capas en el generador de prompts específico del video.
prompt_alpha (`float`, *opcional*, valor predeterminado 0.1) : Valor alfa a utilizar en el generador de prompts específico para video.
prompt_hidden_act (`str` o `function`, *opcional*, valor predeterminado `"quick_gelu"`) : La función de activación no lineal (función o cadena) en el generador de prompts específico de video. Si es una cadena, se admiten `"gelu"`, `"relu"`, `"selu"` y `"gelu_new"` `"quick_gelu"`.
prompt_num_attention_heads (`int`, *opcional*, valor predeterminado 8) : Número de cabezas de atención en la atención cruzada del generador de prompts específico del video.
prompt_attention_dropout (`float`, *opcional*, valor predeterminado 0.0) : La probabilidad de dropout para las capas de atención en el generador de prompts específico de video.
prompt_projection_dropout (`float`, *opcional*, valor predeterminado 0.0) : La probabilidad de dropout para las capas de proyección en el generador de prompts específico de video.
logit_scale_init_value (`float`, *opcional*, valor predeterminado `2.6592`) : El valor inicial del parámetro *logit_scale*.
initializer_factor (`float`, *opcional*, valor predeterminado `1.0`) : Un factor para inicializar todas las matrices de pesos (debe mantenerse en 1, se usa internamente para pruebas de inicialización).
Esta es la clase de configuración para almacenar la configuración de un X ClipModel. Se utiliza para instanciar un modelo X Clip según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
## XCLIPTextConfig[[transformers.XCLIPTextConfig]]
#### transformers.XCLIPTextConfig[[transformers.XCLIPTextConfig]]
```python
transformers.XCLIPTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 77, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/configuration_x_clip.py#L27)
**Parámetros:**
vocab_size (`int`, *opcional*, valor predeterminado `49408`) : Tamaño del vocabulario del modelo. Define el número de tokens diferentes que pueden representarse mediante `input_ids`.
hidden_size (`int`, *opcional*, valor predeterminado `512`) : Dimensión de las representaciones ocultas.
intermediate_size (`int`, *opcional*, valor predeterminado `2048`) : Dimensión de las representaciones MLP.
num_hidden_layers (`int`, *opcional*, valor predeterminado `12`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `8`) : Número de cabezas de atención para cada capa de atención en el decodificador del Transformer.
max_position_embeddings (`int`, *opcional*, valor predeterminado `77`) : La longitud máxima de secuencia con la que se podría utilizar este modelo.
hidden_act (`str`, *opcional*, valor predeterminado `quick_gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-05`) : El epsilon utilizado por las capas de normalización de capas.
attention_dropout (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La proporción de dropout para las probabilidades de atención.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
initializer_factor (`float`, *opcional*, valor predeterminado `1.0`) : Un factor para inicializar todas las matrices de pesos (debe mantenerse en 1, se usa internamente para pruebas de inicialización).
pad_token_id (`int`, *opcional*, valor predeterminado `1`) : Id de token utilizado para el relleno en el vocabulario.
bos_token_id (`int`, *opcional*, valor predeterminado `0`) : Id de token utilizado para el inicio de la secuencia en el vocabulario.
eos_token_id (`Union[int, list[int]]`, *opcional*, valor predeterminado `2`) : Identificador de token utilizado para el fin de la secuencia en el vocabulario.
Esta es la clase de configuración para almacenar la configuración de un X ClipModel. Se utiliza para instanciar un modelo X Clip según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import XCLIPTextModel, XCLIPTextConfig
>>> # Initializing a XCLIPTextModel with microsoft/xclip-base-patch32 style configuration
>>> configuration = XCLIPTextConfig()
>>> # Initializing a XCLIPTextConfig from the microsoft/xclip-base-patch32 style configuration
>>> model = XCLIPTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## XCLIPVisionConfig[[transformers.XCLIPVisionConfig]]
#### transformers.XCLIPVisionConfig[[transformers.XCLIPVisionConfig]]
```python
transformers.XCLIPVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, mit_hidden_size: int = 512, mit_intermediate_size: int = 2048, mit_num_hidden_layers: int = 1, mit_num_attention_heads: int = 8, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 32, num_frames: int = 8, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, drop_path_rate: float | int = 0.0)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/configuration_x_clip.py#L65)
**Parámetros:**
hidden_size (`int`, *opcional*, valor predeterminado `768`) : Dimensión de las representaciones ocultas.
intermediate_size (`int`, *opcional*, valor predeterminado `3072`) : Dimensión de las representaciones MLP.
num_hidden_layers (`int`, *opcional*, valor predeterminado `12`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `12`) : Número de cabezas de atención para cada capa de atención en el decodificador Transformer.
mit_hidden_size (`int`, *opcional*, valor predeterminado 512) : Dimensionalidad de las capas del codificador del Multiframe Integration Transformer (MIT).
mit_intermediate_size (`int`, *opcional*, valor predeterminado 2048) : Dimensionalidad de la capa "intermedia" (es decir, de retroalimentación) en el Multiframe Integration Transformer (MIT).
mit_num_hidden_layers (`int`, *opcional*, valor predeterminado: 1) : Número de capas ocultas en el Multiframe Integration Transformer (MIT).
mit_num_attention_heads (`int`, *opcional*, valor predeterminado: 8) : Número de cabezas de atención para cada capa de atención en el Multiframe Integration Transformer (MIT).
num_channels (`int`, *opcional*, valor predeterminado `3`) : El número de canales de entrada.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `224`) : El tamaño (resolución) de cada imagen.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `32`) : El tamaño (resolución) de cada parche.
num_frames (`int`, *opcional*, valor predeterminado: 8) : El número de fotogramas en cada video.
hidden_act (`str`, *opcional*, valor predeterminado `quick_gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-05`) : El epsilon utilizado por las capas de normalización de capas.
attention_dropout (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La proporción de dropout para las probabilidades de atención.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
initializer_factor (`float`, *opcional*, valor predeterminado `1.0`) : Un factor para inicializar todas las matrices de pesos (debe mantenerse en 1, se usa internamente para pruebas de inicialización).
drop_path_rate (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : Tasa de drop path para la fusión de parches.
Esta es la clase de configuración para almacenar la configuración de un X ClipModel. Se utiliza para instanciar un modelo X Clip según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import XCLIPVisionModel, XCLIPVisionConfig
>>> # Initializing a XCLIPVisionModel with microsoft/xclip-base-patch32 style configuration
>>> configuration = XCLIPVisionConfig()
>>> # Initializing a XCLIPVisionModel model from the microsoft/xclip-base-patch32 style configuration
>>> model = XCLIPVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## XCLIPModel[[transformers.XCLIPModel]]
#### transformers.XCLIPModel[[transformers.XCLIPModel]]
```python
transformers.XCLIPModel(config: XCLIPConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L914)
**Parámetros:**
config ([XCLIPConfig](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo X Clip sin procesar, que genera estados ocultos crudos sin ninguna cabeza específica en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.XCLIPModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L981)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando `image_processor_class`. Consulte `image_processor_class.__call__` para obtener más detalles (`processor_class` utiliza `image_processor_class` para procesar las imágenes).
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
return_loss (`bool`, *opcional*) : Indica si se debe devolver la pérdida contrastiva.
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `False`) : Si se debe interpolar las codificaciones de posición preentrenadas.
**Devuelve:** `XCLIPOutput` o `tuple(torch.Tensor)`
Un `XCLIPOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([XCLIPConfig](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPConfig)) y las entradas.
El método forward de [XCLIPModel](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPModel) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, devuelto cuando `return_loss` es `True`) -- Pérdida contrastiva para la similitud entre video y texto.
- **logits_per_text** (`torch.Tensor` de forma `(text_batch_size, video_batch_size)`) -- Las puntuaciones de producto punto escalado entre `text_embeds` y `video_embeds`. Esto representa las puntuaciones de similitud texto-vídeo.
- **text_embeds** (`torch.Tensor` de forma `(batch_size, output_dim`) -- Las incrustaciones de texto obtenidas al aplicar la capa de proyección a la salida agrupada de [XCLIPTextModel](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPTextModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- La salida del [XCLIPTextModel](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- La salida del [XCLIPVisionModel](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPVisionModel).
- **logits_per_video** (`torch.Tensor` de forma `(video_batch_size, text_batch_size)`) -- Las puntuaciones de producto punto escalado entre `video_embeds` y `text_embeds`. Esto representa las puntuaciones de similitud entre video y texto.
- **video_embeds** (`torch.Tensor` de forma `(batch_size, output_dim`) -- Las incrustaciones de vídeo obtenidas al aplicar la capa de proyección a la salida agrupada de [XCLIPVisionModel](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPVisionModel).
- **mit_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- La salida de `XCLIPMultiframeIntegrationTransformer` (MIT, por sus siglas en inglés).
Ejemplos:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 8 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = processor(
... text=["playing sports", "eating spaghetti", "go shopping"],
... videos=list(video),
... return_tensors="pt",
... padding=True,
... )
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> logits_per_video = outputs.logits_per_video # this is the video-text similarity score
>>> probs = logits_per_video.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(probs)
tensor([[1.9496e-04, 9.9960e-01, 2.0825e-04]])
```
#### get_text_features[[transformers.XCLIPModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L946)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
**Devuelve:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([XCLIPConfig](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPConfig)) y las entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> import torch
>>> from transformers import AutoTokenizer, AutoModel
>>> tokenizer = AutoTokenizer.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_video_features[[transformers.XCLIPModel.get_video_features]]
```python
get_video_features(pixel_values: Tensor, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L1141)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener mediante `image_processor_class`. Consulte `image_processor_class.__call__` para más detalles (`processor_class` utiliza `image_processor_class` para procesar las imágenes).
**Devuelve:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([XCLIPConfig](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPConfig)) y las entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 8 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = processor(videos=list(video), return_tensors="pt")
>>> video_features = model.get_video_features(**inputs)
```
## XCLIPTextModel[[transformers.XCLIPTextModel]]
#### transformers.XCLIPTextModel[[transformers.XCLIPTextModel]]
```python
transformers.XCLIPTextModel(config: XCLIPTextConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L549)
**Parámetros:**
config ([XCLIPTextConfig](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPTextConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo de texto de XCLIP sin ninguna cabeza ni proyección en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.XCLIPTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L563)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
**Devuelve:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([XCLIPConfig](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPConfig)) y las entradas.
El método forward de [XCLIPTextModel](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPTextModel) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import AutoTokenizer, XCLIPTextModel
>>> model = XCLIPTextModel.from_pretrained("microsoft/xclip-base-patch32")
>>> tokenizer = AutoTokenizer.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## XCLIPVisionModel[[transformers.XCLIPVisionModel]]
#### transformers.XCLIPVisionModel[[transformers.XCLIPVisionModel]]
```python
transformers.XCLIPVisionModel(config: XCLIPVisionConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L647)
**Parámetros:**
config ([XCLIPVisionConfig](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPVisionConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo de visión de XCLIP sin ninguna cabeza ni proyección en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.XCLIPVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor], interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L663)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando `image_processor_class`. Consulte `image_processor_class.__call__` para obtener más detalles (`processor_class` utiliza `image_processor_class` para procesar las imágenes).
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `False`) : Si se debe interpolar las codificaciones de posición preentrenadas.
**Devuelve:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([XCLIPConfig](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPConfig)) y las entradas.
El método forward de [XCLIPVisionModel](/docs/transformers/v5.23.0/es/model_doc/xclip#transformers.XCLIPVisionModel) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, XCLIPVisionModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 16 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = XCLIPVisionModel.from_pretrained("microsoft/xclip-base-patch32")
>>> pixel_values = processor(videos=list(video), return_tensors="pt").pixel_values
>>> batch_size, num_frames, num_channels, height, width = pixel_values.shape
>>> pixel_values = pixel_values.reshape(-1, num_channels, height, width)
>>> outputs = model(pixel_values)
>>> last_hidden_state = outputs.last_hidden_state
```