# TVP
## Genel Bakış
Text-visual prompting (TVP) çerçevesi, Yimeng Zhang, Xin Chen, Jinghan Jia, Sijia Liu ve Ke Ding tarafından [Text-Visual Prompting for Efficient 2D Temporal Video Grounding](https://huggingface.co/papers/2303.04995) adlı makalede önerilmiştir.
Makalenin özeti aşağıdaki gibidir:
*Bu makalede, uzun ve kesilmemiş bir video içinde bir metin cümlesiyle tanımlanan anların başlangıç/bitiş zaman noktalarını tahmin etmeyi amaçlayan zamansal video yerelleştirme (TVG) sorununu inceliyoruz. İnce taneli 3B görsel özelliklerden faydalanarak, TVG teknikleri son yıllarda kayda değer ilerlemeler kaydetmiştir. Ancak, 3B konvolüsyonel sinir ağlarının (CNN) yüksek karmaşıklığı, yoğun 3B görsel özelliklerin çıkarılmasını zaman alıcı hale getirmekte ve bu da yoğun bellek ve hesaplama kaynakları gerektirmektedir. Verimli TVG'ye yönelik, TVG modelinin hem görsel girdilerine hem de metinsel özelliklerine optimize edilmiş bozuntu desenlerini (bunlara 'prompt' diyoruz) entegre eden yeni bir metin-görsel promptlama (TVP) çerçevesi öneriyoruz. 3B CNN'lerle keskin bir zıtlık içinde, TVP'nin, yalnızca düşük karmaşıklıktaki seyrek 2B görsel özellikleri kullanarak 2B bir TVG modelinde görme kodlayıcı ve dil kodlayıcısının etkili bir şekilde birlikte eğitilmesine olanak tanıdığını ve çapraz modallı özellik füzyonunun performansını iyileştirdiğini gösteriyoruz. Ayrıca, TVG'nin verimli öğrenimi için Zamansal-Mesafe IoU (TDIoU) kaybı öneriyoruz. Charades-STA ve ActivityNet Captions veri kümeleri olmak üzere iki referans veri kümesi üzerindeki deneyler, önerilen TVP'nin 2B TVG performansını önemli ölçüde artırdığını (örneğin, Charades-STA'da %9,79 ve ActivityNet Captions'ta %30,77 iyileşme) ve 3B görsel özellikler kullanan TVG'ye kıyasla 5× çıkarım hızlandırması sağladığını deneysel olarak göstermektedir.*
Bu araştırma, bir metin cümlesiyle tanımlanan belirli olayların uzun bir videodaki başlangıç ve bitiş zamanlarını belirleme süreci olan zamansal video yerelleştirmeyi (TVG) ele alır. TVG'yi geliştirmek için metin-görsel tetikleme (TVP) önerilmektedir. TVP, TVG modelinin hem görsel (görsel tabanlı) hem de metinsel (kelime tabanlı) girdi bileşenlerine, 'tetikleyici' (prompt) olarak bilinen özel olarak tasarlanmış kalıpların entegre edilmesini içerir. Bu tetikleyiciler, ek uzamsal-zamansal bağlam sağlayarak modelin videodaki olay zamanlamalarını doğru bir şekilde belirleme yeteneğini artırır. Yaklaşım, 3D girdilerin yerine 2D görsel girdiler kullanır. 3D girdiler daha fazla uzamsal-zamansal ayrıntı sunsa da işlenmeleri daha fazla zaman alır. Tetikleme yöntemiyle 2D girdilerin kullanılması, benzer düzeyde bağlam ve doğruluğu daha verimli bir şekilde sağlamayı amaçlar.
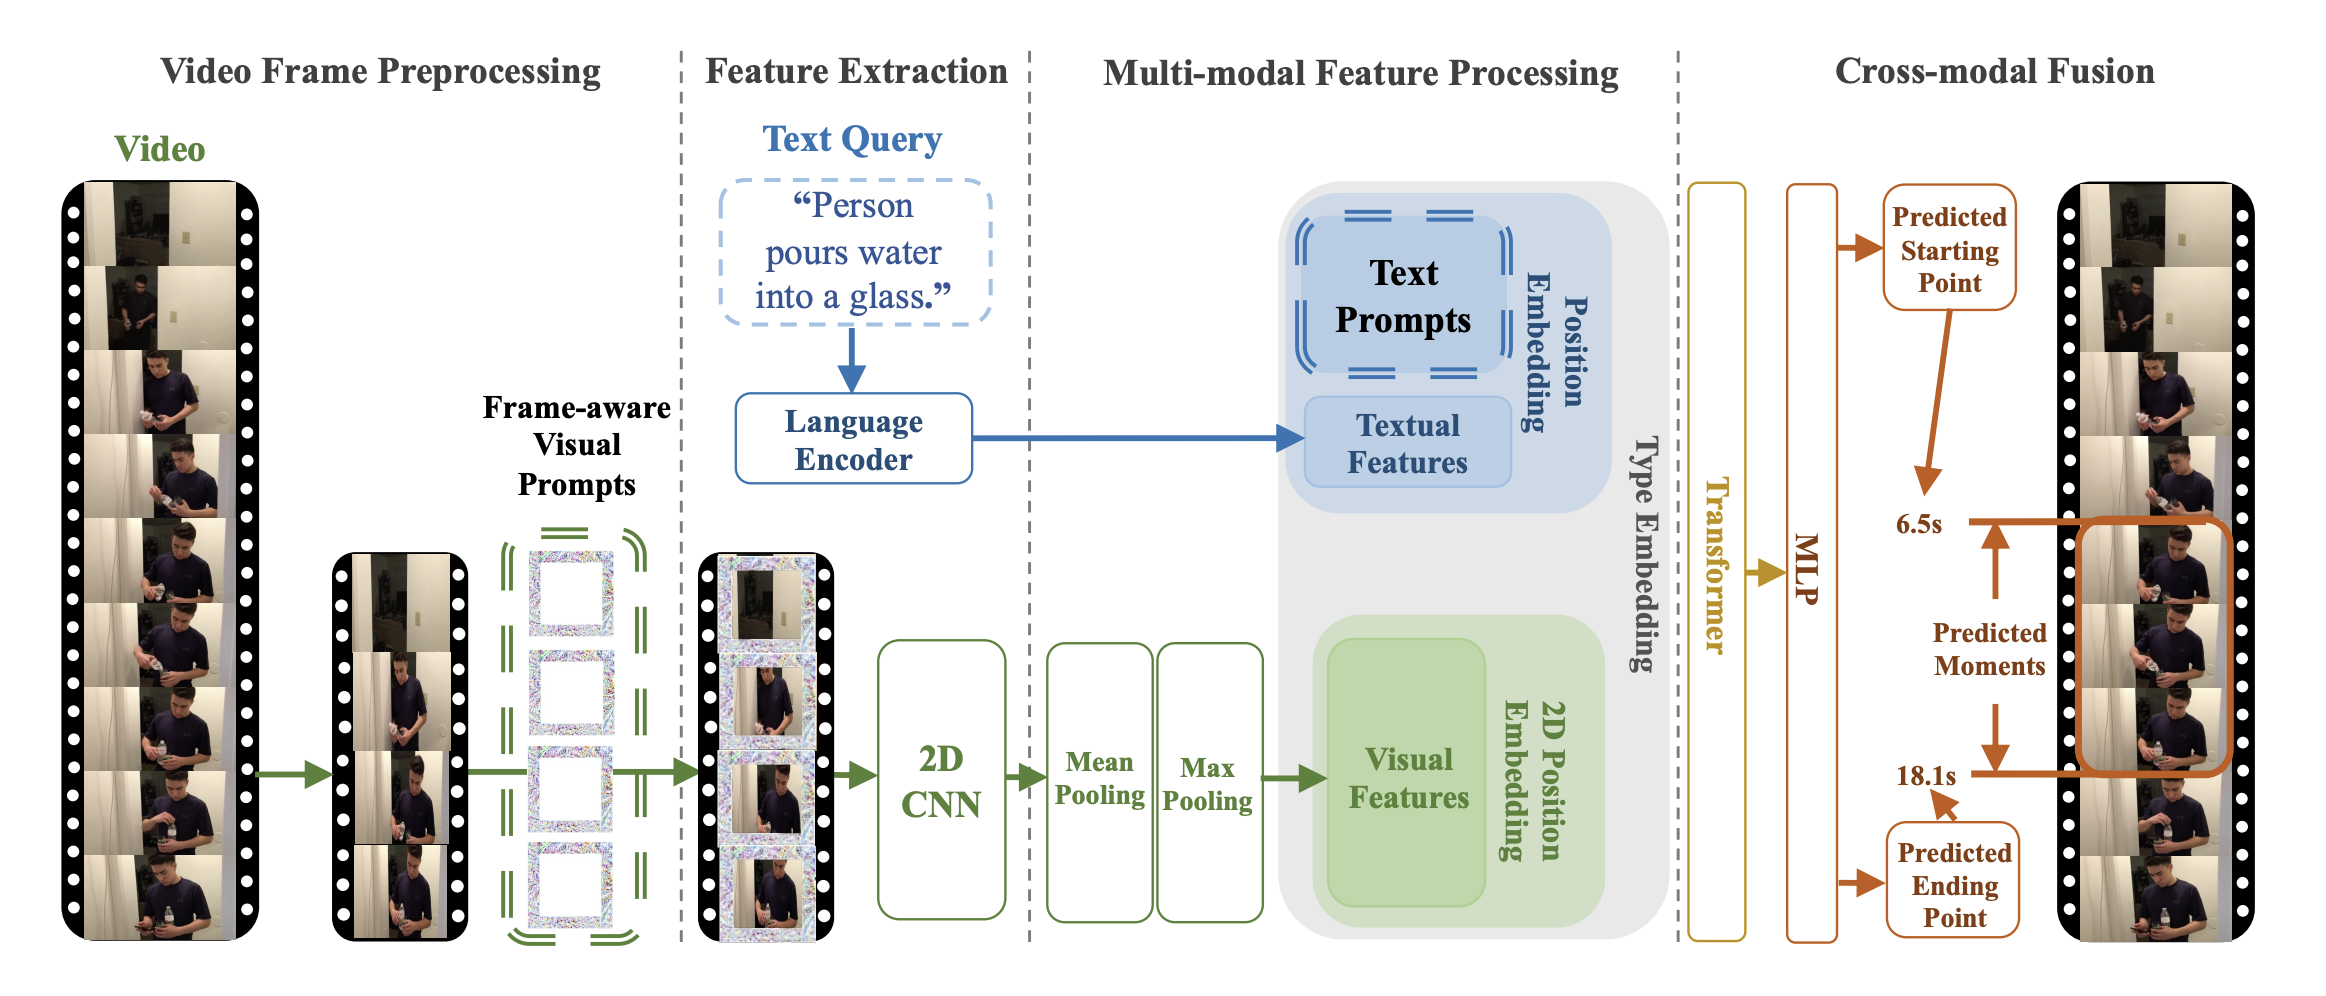 TVP mimarisi. Orijinal makaleden alınmıştır.
Bu model [Jiqing Feng](https://huggingface.co/Jiqing) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/intel/TVP) bulunabilir.
## Kullanım ipuçları ve örnekleri
Prompts, girdi video karelerine veya metin özelliklerine eklenecek optimize edilmiş bozuntulu (perturbation) desenlerdir. Universal set, herhangi bir girdi için aynı tam prompt setinin kullanılması anlamına gelir; bu, bu promptların girdinin içeriğinden bağımsız olarak tüm video karelerine ve metin özelliklerine tutarlı bir şekilde eklendiği demektir.
TVP, bir görsel kodlayıcıdan ve çapraz modallı kodlayıcıdan oluşur. Sırasıyla örneklenen video karelerine ve metinsel özelliklere entegre edilecek evrensel bir görsel istem (prompt) ve metin istemi (prompt) seti. Özellikle, farklı bir görsel istem seti, tek bir kırpılmamış videonun eşit aralıklarla örneklenen karelerine sırayla uygulanır.
Bu modelin amacı, zamanlamalı video yerelleştirme (TVG) problemlerine hem görsel girdilere hem de metinsel özelliklere eğitilebilir istemler (prompts) entegre etmektir. İlke olarak, önerilen mimaride herhangi bir görsel veya çapraz modlu kodlayıcı (encoder) kullanılabilir.
[TvpProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpProcessor), metni kodlamak ve sırasıyla görüntüleri hazırlamak için [BertTokenizer](/docs/transformers/v5.23.0/tr/model_doc/lxmert#transformers.BertTokenizer) ve [TvpImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpImageProcessor) bileşenlerini tek bir örnekte birleştirir.
Aşağıdaki örnek, [TvpProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpProcessor) ve [TvpForVideoGrounding](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpForVideoGrounding) kullanarak zamansal video yerelleştirmenin nasıl çalıştırılacağını gösterir.
```python
import av
import cv2
import numpy as np
from huggingface_hub import hf_hub_download
from transformers import AutoProcessor, TvpForVideoGrounding
def pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
'''
Convert the video from its original fps to the target_fps and decode the video with PyAV decoder.
Args:
container (container): pyav container.
sampling_rate (int): frame sampling rate (interval between two sampled frames).
num_frames (int): number of frames to sample.
clip_idx (int): if clip_idx is -1, perform random temporal sampling.
If clip_idx is larger than -1, uniformly split the video to num_clips
clips, and select the clip_idx-th video clip.
num_clips (int): overall number of clips to uniformly sample from the given video.
target_fps (int): the input video may have different fps, convert it to
the target video fps before frame sampling.
Returns:
frames (tensor): decoded frames from the video. Return None if the no
video stream was found.
fps (float): the number of frames per second of the video.
'''
video = container.streams.video[0]
fps = float(video.average_rate)
clip_size = sampling_rate * num_frames / target_fps * fps
delta = max(num_frames - clip_size, 0)
start_idx = delta * clip_idx / num_clips
end_idx = start_idx + clip_size - 1
timebase = video.duration / num_frames
video_start_pts = int(start_idx * timebase)
video_end_pts = int(end_idx * timebase)
seek_offset = max(video_start_pts - 1024, 0)
container.seek(seek_offset, any_frame=False, backward=True, stream=video)
frames = {}
for frame in container.decode(video=0):
if frame.pts < video_start_pts:
continue
frames[frame.pts] = frame
if frame.pts > video_end_pts:
break
frames = [frames[pts] for pts in sorted(frames)]
return frames, fps
def decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
'''
Decode the video and perform temporal sampling.
Args:
container (container): pyav container.
sampling_rate (int): frame sampling rate (interval between two sampled frames).
num_frames (int): number of frames to sample.
clip_idx (int): if clip_idx is -1, perform random temporal sampling.
If clip_idx is larger than -1, uniformly split the video to num_clips
clips, and select the clip_idx-th video clip.
num_clips (int): overall number of clips to uniformly sample from the given video.
target_fps (int): the input video may have different fps, convert it to
the target video fps before frame sampling.
Returns:
frames (tensor): decoded frames from the video.
'''
assert clip_idx >= -2, f"Not a valid clip_idx {clip_idx}"
frames, fps = pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps)
clip_size = sampling_rate * num_frames / target_fps * fps
index = np.linspace(0, clip_size - 1, num_frames)
index = np.clip(index, 0, len(frames) - 1).astype(np.int64)
frames = np.array([frames[idx].to_rgb().to_ndarray() for idx in index])
frames = frames.transpose(0, 3, 1, 2)
return frames
file = hf_hub_download(repo_id="Intel/tvp_demo", filename="AK2KG.mp4", repo_type="dataset")
model = TvpForVideoGrounding.from_pretrained("Intel/tvp-base", device_map="auto")
decoder_kwargs = dict(
container=av.open(file, metadata_errors="ignore"),
sampling_rate=1,
num_frames=model.config.num_frames,
clip_idx=0,
num_clips=1,
target_fps=3,
)
raw_sampled_frms = decode(**decoder_kwargs)
text = "a person is sitting on a bed."
processor = AutoProcessor.from_pretrained("Intel/tvp-base")
model_inputs = processor(
text=[text], videos=list(raw_sampled_frms), return_tensors="pt", max_text_length=100#, size=size
)
model_inputs["pixel_values"] = model_inputs["pixel_values"].to(model.dtype)
output = model(**model_inputs)
def get_video_duration(filename):
cap = cv2.VideoCapture(filename)
if cap.isOpened():
rate = cap.get(5)
frame_num = cap.get(7)
duration = frame_num/rate
return duration
return -1
duration = get_video_duration(file)
start, end = processor.post_process_video_grounding(output.logits, duration)
print(f"The time slot of the video corresponding to the text \"{text}\" is from {start}s to {end}s")
```
İpuçları:
- Bu TVP uygulaması, metin gömme vektörlerini üretmek için [BertTokenizer](/docs/transformers/v5.23.0/tr/model_doc/lxmert#transformers.BertTokenizer) ve görsel gömme vektörlerini hesaplamak için Resnet-50 modelini kullanır.
- Önceden eğitilmiş [tvp-base](https://huggingface.co/Intel/tvp-base) için kontrol noktaları yayınlandı.
- TVP'nin Zamanlı Video Yerelleştirme görevindeki performansına ilişkin olarak [Tablo 2](https://huggingface.co/papers/2303.04995)'ye bakın.
## TvpConfig[[transformers.TvpConfig]]
#### transformers.TvpConfig[[transformers.TvpConfig]]
```python
transformers.TvpConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, distance_loss_weight: float = 1.0, duration_loss_weight: float = 0.1, visual_prompter_type: str = 'framepad', visual_prompter_apply: str = 'replace', visual_prompt_size: int = 96, max_img_size: int = 448, num_frames: int = 48, vocab_size: int = 30522, type_vocab_size: int = 2, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, max_position_embeddings: int = 512, max_grid_col_position_embeddings: int = 100, max_grid_row_position_embeddings: int = 100, hidden_dropout_prob: float | int = 0.1, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-12, initializer_range: float = 0.02, attention_probs_dropout_prob: float | int = 0.1, pad_token_id: int | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/configuration_tvp.py#L25)
**Parametreler:**
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Omurga modelinin yapılandırması.
distance_loss_weight (`float`, *isteğe bağlı*, varsayılan 1.0) : Mesafe kaybının ağırlığı.
duration_loss_weight (`float`, *isteğe bağlı*, varsayılan 0.1) : Süre kaybının ağırlığı.
visual_prompter_type (`str`, *isteğe bağlı*, varsayılan `"framepad"`) : Görsel istem türü. Dolgu türü. Framepad, her karede dolgu yapılması anlamına gelir. "framepad" veya "framedownpad" değerlerinden biri olmalıdır
visual_prompter_apply (`str`, *isteğe bağlı*, varsayılan `"replace"`) : Görsel istemin uygulanma yöntemi. Replace, görsel girdilerdeki orijinal değeri değiştirmek için istemin değerinin kullanılacağı anlamına gelir. "replace", "add" veya "remove" değerlerinden biri olmalıdır.
visual_prompt_size (`int`, *isteğe bağlı*, varsayılan 96) : Görsel istemin boyutu.
max_img_size (`int`, *isteğe bağlı*, varsayılan 448) : Karelerin maksimum boyutu.
num_frames (`int`, *isteğe bağlı*, varsayılan 48) : Bir videodan çıkarılan kare sayısı.
vocab_size (`int`, *isteğe bağlı*, varsayılan `30522`) : Modelin sözlük boyutu. `input_ids` tarafından temsil edilebilecek farklı token sayısını tanımlar.
type_vocab_size (`int`, *isteğe bağlı*, varsayılan `2`) : `token_type_ids` için sözlük boyutu.
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
intermediate_size (`int`, *isteğe bağlı*, varsayılan `3072`) : MLP temsil boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
max_position_embeddings (`int`, *isteğe bağlı*, varsayılan 512) : Bu modelin kullanılabileceği maksimum dizi uzunluğu. Genellikle, olası durumlara karşı bu değeri büyük bir sayı olarak ayarlayın (ör. 512, 1024 veya 2048).
max_grid_col_position_embeddings (`int`, *isteğe bağlı*, varsayılan 100) : Bir video karesinden alınacak en büyük yatay yama sayısı.
max_grid_row_position_embeddings (`int`, *isteğe bağlı*, varsayılan 100) : Bir video karesinden alınacak en büyük dikey yama sayısı.
hidden_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Gömme, kodlayıcı ve havuzlayıcıdaki tüm tam bağlı katmanlar için dropout olasılığı.
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-12`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
attention_probs_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Dikkat olasılıkları için dropout oranı.
pad_token_id (`int`, *isteğe bağlı*) : Sözlükte dolgu için kullanılan token kimliği.
Bu, bir TvpModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Tvp modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, [Intel/tvp-base](https://huggingface.co/Intel/tvp-base) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
## TvpImageProcessor[[transformers.TvpImageProcessor]]
#### transformers.TvpImageProcessor[[transformers.TvpImageProcessor]]
```python
transformers.TvpImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_tvp.py#L50)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'longest_edge' : 448}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 448, 'width': 448}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `2`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 448, 'width': 448}`): Görsellerin boyutlandırılacağı `{"height": int, "width" int}` boyutu. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe boyutlandırılır. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_flip_channel_order (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_flip_channel_order`) : Görselin kanal sırasının RGB'den BGR'ye çevrilip çevrilmeyeceğini belirtir.
constant_values (`float`, *kwargs* veya `List[float]`, *opsiyonel*, varsayılan `self.constant_values`) : `pad_mode` `'constant'` olduğunda dolgu alanını doldurmak için kullanılan değer.
pad_mode (`str`, *kwargs*, *opsiyonel*, varsayılan `self.pad_mode`) : Kullanılacak dolgu modu — `'constant'`, `'edge'`, `'reflect'` veya `'symmetric'`.
TvpImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.TvpImageProcessor.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]], **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_tvp.py#L72)
**Parametreler:**
videos (`ImageInput` veya `list[ImageInput]` veya `list[list[ImageInput]]`) : Ön işleme tabi tutulacak kareler.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_flip_channel_order (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_flip_channel_order`) : Görselin kanal sırasının RGB'den BGR'ye çevrilip çevrilmeyeceğini belirtir.
constant_values (`float`, *kwargs* veya `List[float]`, *opsiyonel*, varsayılan `self.constant_values`) : `pad_mode` `'constant'` olduğunda dolgu alanını doldurmak için kullanılan değer.
pad_mode (`str`, *kwargs*, *opsiyonel*, varsayılan `self.pad_mode`) : Kullanılacak dolgu modu — `'constant'`, `'edge'`, `'reflect'` veya `'symmetric'`.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## TvpImageProcessorPil[[transformers.TvpImageProcessorPil]]
#### transformers.TvpImageProcessorPil[[transformers.TvpImageProcessorPil]]
```python
transformers.TvpImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_pil_tvp.py#L72)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'longest_edge' : 448}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 448, 'width': 448}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `2`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 448, 'width': 448}`): Görsellerin boyutlandırılacağı `{"height": int, "width" int}` boyutu. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe boyutlandırılır. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_flip_channel_order (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_flip_channel_order`) : Görselin kanal sırasının RGB'den BGR'ye çevrilip çevrilmeyeceğini belirtir.
constant_values (`float`, *kwargs* veya `List[float]`, *opsiyonel*, varsayılan `self.constant_values`) : `pad_mode` `'constant'` olduğunda dolgu alanını doldurmak için kullanılan değer.
pad_mode (`str`, *kwargs*, *opsiyonel*, varsayılan `self.pad_mode`) : Kullanılacak dolgu modu — `'constant'`, `'edge'`, `'reflect'` veya `'symmetric'`.
TvpImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.TvpImageProcessorPil.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]], **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_pil_tvp.py#L94)
**Parametreler:**
videos (`ImageInput` veya `list[ImageInput]` veya `list[list[ImageInput]]`) : Ön işleme tabi tutulacak kareler.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_flip_channel_order (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_flip_channel_order`) : Görselin kanal sırasının RGB'den BGR'ye çevrilip çevrilmeyeceğini belirtir.
constant_values (`float`, *kwargs* veya `List[float]`, *opsiyonel*, varsayılan `self.constant_values`) : `pad_mode` `'constant'` olduğunda dolgu alanını doldurmak için kullanılan değer.
pad_mode (`str`, *kwargs*, *opsiyonel*, varsayılan `self.pad_mode`) : Kullanılacak dolgu modu — `'constant'`, `'edge'`, `'reflect'` veya `'symmetric'`.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## TvpProcessor[[transformers.TvpProcessor]]
#### transformers.TvpProcessor[[transformers.TvpProcessor]]
```python
transformers.TvpProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/processing_tvp.py#L24)
**Parametreler:**
image_processor (`TvpImageProcessor`) : Görüntü işleyici zorunlu bir girdidir.
tokenizer (`BertTokenizer`) : Tokenizer zorunlu bir girdidir.
Bir görüntü işleyiciyi ve bir belirteç oluşturucuyu tek bir işleyicide birleştiren bir TvpProcessor oluşturur.
[TvpProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpProcessor), [TvpImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpImageProcessor) ve [BertTokenizer](/docs/transformers/v5.23.0/tr/model_doc/lxmert#transformers.BertTokenizer) sınıflarının tüm işlevlerini sunar. Daha fazla bilgi için [~TvpImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpImageProcessor) ve [~BertTokenizer](/docs/transformers/v5.23.0/tr/model_doc/lxmert#transformers.BertTokenizer) belgelerine bakın.
#### __call__[[transformers.TvpProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
text (`Union[str, list[str], list[list[str]]]`, *isteğe bağlı*) : Kodlanacak dizi veya dizi topluluğu. Her dizi bir metin veya metin listesi (önceden tokenize edilmiş metin) olabilir. Önceden tokenize edilmiş bir girdi geçirirseniz, toplu girdilerle karışıklığı önlemek için `is_split_into_words=True` değerini ayarlayın.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak video. Piksel değerleri 0 ile 255 arasında değişen tek bir video veya video grubu beklenir. Piksel değerleri 0 ile 1 arasında olan videoları geçiriyorsanız, `do_rescale=False` olarak ayarlayın.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *isteğe bağlı*) : Hazırlanacak ses veya sesler grubu. Her ses, bir NumPy dizisi veya PyTorch tensörü olabilir. NumPy dizisi/PyTorch tensörü durumunda, her sesin şekli (C, T) olmalıdır; burada C kanal sayısı, T ise sesin örnek uzunluğudur.
return_mm_token_type_ids (`bool`, *kwargs*) : Çok modlu yer tutucu token konumlarını gösteren çok modlu token türü kimliklerini döndürüp döndürmeyeceğini belirtir.
return_text_replacement_offsets (`bool`, *kwargs*) : Her çok modlu yer tutucu ve ikamesi için karakter ofsetlerinin döndürülüp döndürülmemesi.
return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *opsiyonel*) : Ayarlanırsa, belirli bir çerçeveye ait tensörleri döndürür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: NumPy `np.ndarray` nesnelerini döndürür.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/tr/main_classes/processors#transformers.ProcessingKwargs), *opsiyonel*) : Her modalite (metin, görüntüler, videolar, ses) için ek işleme seçenekleri. Modelle ilgili parametreler yukarıda listelenmiştir; desteklenen argümanların tam listesi için TypedDict sınıfına bakın.
## TvpModel[[transformers.TvpModel]]
#### transformers.TvpModel[[transformers.TvpModel]]
```python
transformers.TvpModel(config: TvpConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L684)
**Parametreler:**
config ([TvpConfig](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde herhangi bir özel başlık olmadan BaseModelOutputWithPooling nesnesi üreten çıplak Tvp Model transformer.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.TvpModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L707)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yoksayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi kimlikları (input IDs) nedir?](../glossary#input-ids)
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [TvpImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [TvpImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([TvpProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpProcessor), görüntü işleme için [TvpImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpImageProcessor) kullanır).
attention_mask (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
output_attentions (`bool`, *isteğe bağlı*) : Tüm dikkat katmanlarının dikkat tensörlerinin döndürülüp döndürülmediğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `attentions` bölümüne bakın.
output_hidden_states (`bool`, *isteğe bağlı*) : Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `hidden_states` bölümüne bakın.
return_dict (`bool`, *isteğe bağlı*) : Düz bir tuple yerine [ModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.utils.ModelOutput) döndürülecek mi?
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([TvpConfig](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[TvpModel](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpModel
>>> model = TvpModel.from_pretrained("Jiqing/tiny-random-tvp")
>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")
>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)
```
## TvpForVideoGrounding[[transformers.TvpForVideoGrounding]]
#### transformers.TvpForVideoGrounding[[transformers.TvpForVideoGrounding]]
```python
transformers.TvpForVideoGrounding(config: TvpConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L801)
**Parametreler:**
config ([TvpConfig](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde IoU, mesafe ve süre kaybını hesaplayan bir video yerelleştirme kafası bulunan Tvp Modeli.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.TvpForVideoGrounding.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, labels: tuple[torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L810)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yoksayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi kimlikları (input IDs) nedir?](../glossary#input-ids)
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [TvpImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [TvpImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([TvpProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpProcessor), görüntü işleme için [TvpImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpImageProcessor) kullanır).
attention_mask (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
labels (`torch.Tensor`, şekli `(batch_size, 3)`, *isteğe bağlı*) : Etiketler, metne karşılık gelen videonun süresini, başlangıç zamanını ve bitiş zamanını içerir.
output_attentions (`bool`, *isteğe bağlı*) : Tüm dikkat katmanlarının dikkat tensörlerinin döndürülüp döndürülmediğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `attentions` bölümüne bakın.
output_hidden_states (`bool`, *isteğe bağlı*) : Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `hidden_states` bölümüne bakın.
return_dict (`bool`, *isteğe bağlı*) : Düz bir tuple yerine [ModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.utils.ModelOutput) döndürülecek mi?
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** `TvpVideoGroundingOutput` veya `tuple(torch.Tensor)`
`TvpVideoGroundingOutput` veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([TvpConfig](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[TvpForVideoGrounding](/docs/transformers/v5.23.0/tr/model_doc/tvp#transformers.TvpForVideoGrounding) ileri yöntemi, `__call__` özel yöntemini geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *opsiyonel*, `return_loss` `True` olduğunda döndürülür) -- Video yerelleştirme için Temporal-Distance IoU kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, 2)`) -- start_time/duration ve end_time/duration değerlerini içerir. Girdi metinlere karşılık gelen videoların zaman dilimidir.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Örnekler:
```python
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpForVideoGrounding
>>> model = TvpForVideoGrounding.from_pretrained("Jiqing/tiny-random-tvp")
>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")
>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)
```