# OWLv2
## Aperçu
OWLv2 a été proposé dans [Scaling Open-Vocabulary Object Detection](https://huggingface.co/papers/2306.09683) par Matthias Minderer, Alexey Gritsenko et Neil Houlsby. OWLv2 étend [OWL-ViT](owlvit) à l’aide de l’auto-entraînement, qui utilise un détecteur existant pour générer des annotations de boîtes pseudo sur des paires image-texte. Cela entraîne des gains importants par rapport à l’état de l’art précédent pour la détection d’objets en zéro tir.
L'abstract de l'article est le suivant :
*La détection d'objets à vocabulaire ouvert a grandement bénéficié des modèles de vision-langage pré-entraînés, mais reste limitée par la quantité de données d'entraînement de détection disponibles. Bien que les données d'entraînement de détection puissent être étendues en utilisant des paires image-texte du Web comme supervision faible, cela n'a pas été fait à des échelles comparables à celles du pré-entraînement au niveau de l'image. Ici, nous mettons à l'échelle les données de détection par auto-entraînement, qui utilise un détecteur existant pour générer des annotations pseudo-boîtes sur des paires image-texte. Les principaux défis dans la mise à l'échelle de l'auto-entraînement sont le choix de l'espace d'étiquettes, le filtrage des annotations pseudo et l'efficacité de l'entraînement. Nous présentons le modèle OWLv2 et la recette d'auto-entraînement OWL-ST, qui abordent ces défis. OWLv2 surpasse les performances des détecteurs à vocabulaire ouvert de l'état de l'art précédents déjà à des échelles d'entraînement comparables (~10M d'exemples). Cependant, avec OWL-ST, nous pouvons mettre à l'échelle à plus de 1Md d'exemples, ce qui entraîne une amélioration supplémentaire importante : avec une architecture L/14, OWL-ST améliore l'AP sur les classes rares de LVIS, pour lesquelles le modèle n'a vu aucune annotation de boîte humaine, de 31,2 % à 44,6 % (amélioration relative de 43 %). OWL-ST débloque l'entraînement à l'échelle du Web pour la localisation en monde ouvert, de manière similaire à ce qui a été observé pour la classification d'images et la modélisation du langage.*
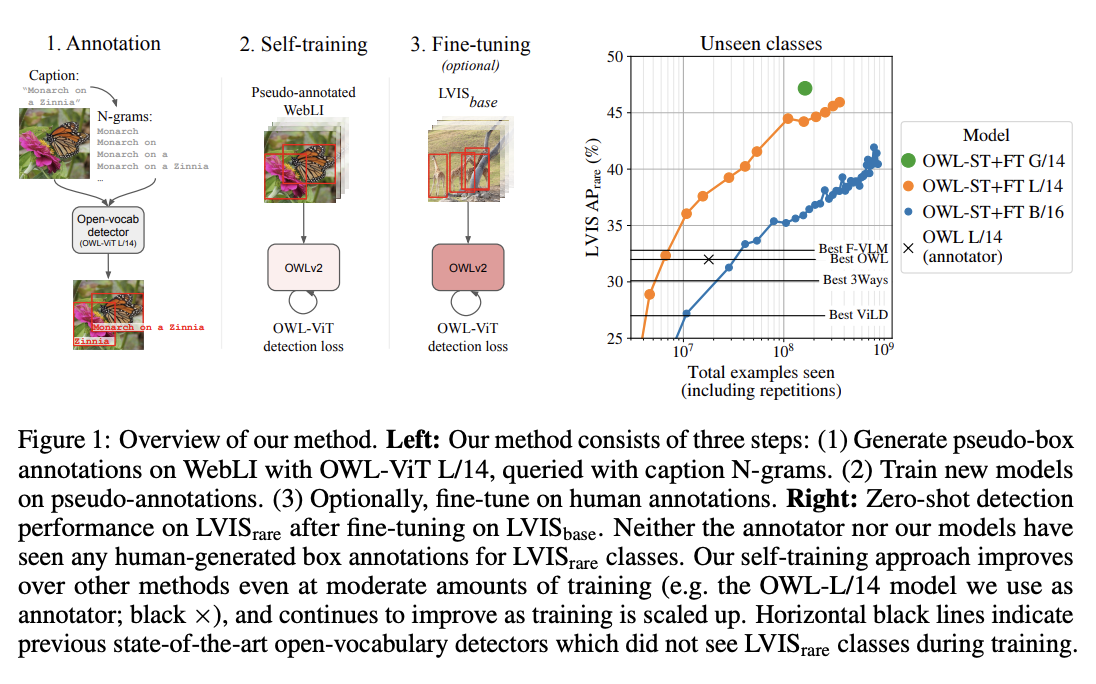 Vue d'ensemble de haut niveau d'OWLv2. Tirée de l'article original.
Ce modèle a été contribué par [nielsr](https://huggingface.co/nielsr). Le code d'origine peut être trouvé [ici](https://github.com/google-research/scenic/tree/main/scenic/projects/owl_vit).
## Exemple d'utilisation
OWLv2 est, tout comme son prédécesseur [OWL-ViT](owlvit), un modèle de détection d'objets conditionné par le texte en zéro tirage. OWL-ViT utilise [CLIP](clip) comme colonne vertébrale multimodale, avec un Transformer de type ViT pour extraire les caractéristiques visuelles et un modèle de langage causal pour extraire les caractéristiques textuelles. Pour utiliser CLIP pour la détection, OWL-ViT supprime la couche de regroupement du jeton final du modèle de vision et attache une tête de classification et de boîte légère à chaque jeton de sortie du transformer. La classification à vocabulaire ouvert est rendue possible en remplaçant les poids de la couche de classification fixe par les plongements de noms de classes obtenus à partir du modèle de texte. Les auteurs entraînent d'abord CLIP de zéro, puis l'ajustent finement de bout en bout avec les têtes de classification et de boîte sur des jeux de données de détection standard, en utilisant une perte d'appariement biparti. Un ou plusieurs requêtes textuelles par image peuvent être utilisés pour effectuer la détection d'objets conditionnée par le texte en zéro tirage.
[Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor) peut être utilisé pour redimensionner (ou remasquer) et normaliser les images pour le modèle, et [CLIPTokenizer](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPTokenizer) est utilisé pour encoder le texte. [Owlv2Processor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Processor) encapsule [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor) et [CLIPTokenizer](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPTokenizer) dans une seule instance afin d’encoder le texte et de préparer les images. L’exemple suivant montre comment effectuer la détection d’objets à l’aide de [Owlv2Processor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Processor) et [Owlv2ForObjectDetection](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ForObjectDetection).
```python
import requests
from PIL import Image
import torch
from transformers import Owlv2Processor, Owlv2ForObjectDetection
processor = Owlv2Processor.from_pretrained("google/owlv2-base-patch16-ensemble")
model = Owlv2ForObjectDetection.from_pretrained("google/owlv2-base-patch16-ensemble", device_map="auto")
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
text_labels = [["a photo of a cat", "a photo of a dog"]]
inputs = processor(text=text_labels, images=image, return_tensors="pt").to(model.device)
outputs = model(**inputs)
# Target image sizes (height, width) to rescale box predictions [batch_size, 2]
target_sizes = torch.tensor([(image.height, image.width)])
# Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
results = processor.post_process_grounded_object_detection(
outputs=outputs, target_sizes=target_sizes, threshold=0.1, text_labels=text_labels
)
# Retrieve predictions for the first image for the corresponding text queries
result = results[0]
boxes, scores, text_labels = result["boxes"], result["scores"], result["text_labels"]
for box, score, text_label in zip(boxes, scores, text_labels):
box = [round(i, 2) for i in box.tolist()]
print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a photo of a cat with confidence 0.614 at location [341.67, 23.39, 642.32, 371.35]
Detected a photo of a cat with confidence 0.665 at location [6.75, 51.96, 326.62, 473.13]
```
## Ressources
- Un notebook de démonstration sur l'utilisation d'OWLv2 pour la détection d'objets en zéro et un tir (guidée par image) peut être trouvé [ici](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/OWLv2).
- [Guide de la tâche de détection d'objets en zéro tir](../tasks/zero_shot_object_detection)
L’architecture d’OWLv2 est identique à celle de [OWL-ViT](owlvit), mais la tête de détection d’objets inclut désormais également un classifieur d’objectness, qui prédit la probabilité (indépendante de la requête) qu’une boîte prédite contienne un objet (par opposition à l’arrière-plan). Le score d’objectness peut être utilisé pour classer ou filtrer les prédictions indépendamment des requêtes textuelles. L’utilisation d’OWLv2 est identique à celle de [OWL-ViT](owlvit), avec un nouveau processeur d’images mis à jour ([Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor)).
## Owlv2Config[[transformers.Owlv2Config]]
#### transformers.Owlv2Config[[transformers.Owlv2Config]]
```python
transformers.Owlv2Config(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, return_dict: bool = True, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, projection_dim: int = 512, logit_scale_init_value: float = 2.6592, initializer_factor: float = 1.0)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/configuration_owlv2.py#L104)
**Paramètres :**
return_dict (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut retourner un `ModelOutput` (dataclass) plutôt qu'un simple tuple.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone de texte.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone visuel.
projection_dim (`int`, *facultatif*, valeur par défaut `512`) : Dimension des couches de projection du texte et de la vision.
logit_scale_init_value (`float`, *facultatif*, valeur par défaut `2.6592`) : La valeur initiale du paramètre *logit_scale*.
initializer_factor (`float`, *facultatif*, par défaut `1.0`) : Un facteur pour l'initialisation de toutes les matrices de poids (doit être maintenu à 1, utilisé en interne pour les tests d'initialisation).
Ceci est la classe de configuration destinée à stocker la configuration d'un Owlv2Model. Elle est utilisée pour instancier un modèle Owlv2 en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [google/owlv2-base-patch16](https://huggingface.co/google/owlv2-base-patch16)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
## Owlv2TextConfig[[transformers.Owlv2TextConfig]]
#### transformers.Owlv2TextConfig[[transformers.Owlv2TextConfig]]
```python
transformers.Owlv2TextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 16, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, pad_token_id: int | None = 0, bos_token_id: int | None = 49406, eos_token_id: int | list[int] | None = 49407)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/configuration_owlv2.py#L28)
**Paramètres :**
vocab_size (`int`, *facultatif*, valeur par défaut `49408`) : Taille du vocabulaire du modèle. Définit le nombre de jetons différents qui peuvent être représentés par `input_ids`.
hidden_size (`int`, *facultatif*, par défaut `512`) : Dimension des représentations cachées.
intermediate_size (`int`, *facultatif*, valeur par défaut `2048`) : Dimension des représentations MLP.
num_hidden_layers (`int`, *facultatif*, par défaut `12`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `8`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
max_position_embeddings (`int`, *facultatif*, valeur par défaut `16`) : La longueur de séquence maximale avec laquelle ce modèle pourrait être utilisé.
hidden_act (`str`, *facultatif*, par défaut `quick_gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *facultatif*, valeur par défaut `1e-05`) : L'épsilon utilisé par les couches de normalisation de couche.
attention_dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
initializer_factor (`float`, *facultatif*, par défaut `1.0`) : Un facteur pour l'initialisation de toutes les matrices de poids (doit être maintenu à 1, utilisé en interne pour les tests d'initialisation).
pad_token_id (`int`, *facultatif*, valeur par défaut `0`) : Identifiant du jeton utilisé pour le bourrage dans le vocabulaire.
bos_token_id (`int`, *facultatif*, valeur par défaut `49406`) : Identifiant du jeton utilisé pour le début de flux dans le vocabulaire.
eos_token_id (`Union[int, list[int]]`, *facultatif*, valeur par défaut `49407`) : Identifiant de jeton utilisé pour la fin de flux dans le vocabulaire.
Ceci est la classe de configuration destinée à stocker la configuration d'un Owlv2Model. Elle est utilisée pour instancier un modèle Owlv2 en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [google/owlv2-base-patch16](https://huggingface.co/google/owlv2-base-patch16)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import Owlv2TextConfig, Owlv2TextModel
>>> # Initializing a Owlv2TextModel with google/owlv2-base-patch16 style configuration
>>> configuration = Owlv2TextConfig()
>>> # Initializing a Owlv2TextConfig from the google/owlv2-base-patch16 style configuration
>>> model = Owlv2TextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Owlv2VisionConfig[[transformers.Owlv2VisionConfig]]
#### transformers.Owlv2VisionConfig[[transformers.Owlv2VisionConfig]]
```python
transformers.Owlv2VisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 768, patch_size: int | list[int] | tuple[int, int] = 16, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/configuration_owlv2.py#L67)
**Paramètres :**
hidden_size (`int`, *facultatif*, par défaut `768`) : Dimension des représentations cachées.
intermediate_size (`int`, *facultatif*, par défaut `3072`) : Dimension des représentations MLP.
num_hidden_layers (`int`, *facultatif*, par défaut `12`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `12`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
num_channels (`int`, *facultatif*, par défaut `3`) : Le nombre de canaux d'entrée.
image_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `768`) : La taille (résolution) de chaque image.
patch_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `16`) : La taille (résolution) de chaque patch.
hidden_act (`str`, *facultatif*, par défaut `quick_gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *facultatif*, valeur par défaut `1e-05`) : L'épsilon utilisé par les couches de normalisation de couche.
attention_dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
initializer_factor (`float`, *facultatif*, par défaut `1.0`) : Un facteur pour l'initialisation de toutes les matrices de poids (doit être maintenu à 1, utilisé en interne pour les tests d'initialisation).
Ceci est la classe de configuration destinée à stocker la configuration d'un Owlv2Model. Elle est utilisée pour instancier un modèle Owlv2 en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [google/owlv2-base-patch16](https://huggingface.co/google/owlv2-base-patch16)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import Owlv2VisionConfig, Owlv2VisionModel
>>> # Initializing a Owlv2VisionModel with google/owlv2-base-patch16 style configuration
>>> configuration = Owlv2VisionConfig()
>>> # Initializing a Owlv2VisionModel model from the google/owlv2-base-patch16 style configuration
>>> model = Owlv2VisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Owlv2ImageProcessor[[transformers.Owlv2ImageProcessor]]
#### transformers.Owlv2ImageProcessor[[transformers.Owlv2ImageProcessor]]
```python
transformers.Owlv2ImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/image_processing_owlv2.py#L110)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 960, 'width': 960}`) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `None`) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.48145466, 0.4578275, 0.40821073]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.26862954, 0.26130258, 0.27577711]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*, valeur par défaut `None`) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
Construit un processeur d’images Owlv2ImageProcessor.
#### prétraiter[[transformers.Owlv2ImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *facultatif*) : Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant qu'argument nommé ne fonctionne pas. Par exemple, `preprocess(images, masks=masks)` est l'option recommandée, mais cela peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas, vous pouvez utiliser à la place `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
#### post_process_object_detection[[transformers.Owlv2ImageProcessor.post_process_object_detection]]
```python
post_process_object_detection(outputs: Owlv2ObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/image_processing_owlv2.py#L136)
**Paramètres :**
outputs (`Owlv2ObjectDetectionOutput`) : Sorties brutes du modèle.
threshold (`float`, *facultatif*, valeur par défaut 0,1) : Seuil de score à appliquer pour conserver les prédictions de détection d'objets.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *facultatif*) : Tenseur de forme `(batch_size, 2)` ou liste de tuples (`tuple[int, int]`) contenant la taille cible `(height, width)` de chaque image du lot. Si non défini, les prédictions ne seront pas redimensionnées.
**Retourne :** `list[Dict]`
Une liste de dictionnaires, chaque dictionnaire contenant les clés suivantes :
- "scores" : les scores de confiance pour chaque boîte prédite sur l'image.
- "labels" : Index des classes prédites par le modèle sur l'image.
- "boxes" : Boîtes englobantes de l'image au format (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
Convertit la sortie brute de [Owlv2ForObjectDetection](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ForObjectDetection) en boîtes englobantes finales au format (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
#### post_process_image_guided_detection[[transformers.Owlv2ImageProcessor.post_process_image_guided_detection]]
```python
post_process_image_guided_detection(outputs, threshold = 0.0, nms_threshold = 0.3, target_sizes = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/image_processing_owlv2.py#L189)
**Paramètres :**
outputs (`Owlv2ImageGuidedObjectDetectionOutput`) : Sorties brutes du modèle.
threshold (`float`, *facultatif*, valeur par défaut 0.0) : Seuil de confiance minimal à utiliser pour filtrer les boîtes prédites.
nms_threshold (`float`, *facultatif*, par défaut 0,3) : Seuil d'IoU pour la suppression du non-maximum des boîtes superposées.
target_sizes (`torch.Tensor`, *facultatif*) : Tenseur de forme (batch_size, 2) où chaque entrée correspond à la (hauteur, largeur) de l'image correspondante dans le lot. Si défini, les boîtes englobantes normalisées prédites sont remises à l'échelle des tailles cibles. Si laissé à None, les prédictions ne seront pas dénormalisées.
**Retourne :** `list[Dict]`
Une liste de dictionnaires, chaque dictionnaire contenant les scores, les étiquettes et les boîtes pour une image du lot, telles que prédites par le modèle. Toutes les étiquettes sont définies sur None, car `Owlv2ForObjectDetection.image_guided_detection` effectue une détection d'objets en une seule passe.
Convertit la sortie de [Owlv2ForObjectDetection.image_guided_detection()](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ForObjectDetection.image_guided_detection) dans le format attendu par l'API COCO.
## Owlv2ImageProcessorPil[[transformers.Owlv2ImageProcessorPil]]
#### transformers.Owlv2ImageProcessorPil[[transformers.Owlv2ImageProcessorPil]]
```python
transformers.Owlv2ImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/image_processing_pil_owlv2.py#L190)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 960, 'width': 960}`) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `None`) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.48145466, 0.4578275, 0.40821073]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.26862954, 0.26130258, 0.27577711]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*, valeur par défaut `None`) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
Construit un processeur d’images Owlv2ImageProcessor.
#### prétraiter[[transformers.Owlv2ImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *facultatif*) : Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant qu'argument nommé ne fonctionne pas. Par exemple, `preprocess(images, masks=masks)` est l'option recommandée, mais cela peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas, vous pouvez utiliser à la place `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
#### post_process_object_detection[[transformers.Owlv2ImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs: Owlv2ObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/image_processing_pil_owlv2.py#L216)
**Paramètres :**
outputs (`Owlv2ObjectDetectionOutput`) : Sorties brutes du modèle.
threshold (`float`, *facultatif*, valeur par défaut 0,1) : Seuil de score à appliquer pour conserver les prédictions de détection d'objets.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *facultatif*) : Tenseur de forme `(batch_size, 2)` ou liste de tuples (`tuple[int, int]`) contenant la taille cible `(height, width)` de chaque image du lot. Si non défini, les prédictions ne seront pas redimensionnées.
**Retourne :** `list[Dict]`
Une liste de dictionnaires, chaque dictionnaire contenant les clés suivantes :
- "scores" : les scores de confiance pour chaque boîte prédite sur l'image.
- "labels" : Index des classes prédites par le modèle sur l'image.
- "boxes" : Boîtes englobantes de l'image au format (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
Convertit la sortie brute de [Owlv2ForObjectDetection](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ForObjectDetection) en boîtes englobantes finales au format (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
#### post_process_image_guided_detection[[transformers.Owlv2ImageProcessorPil.post_process_image_guided_detection]]
```python
post_process_image_guided_detection(outputs, threshold = 0.0, nms_threshold = 0.3, target_sizes = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/image_processing_pil_owlv2.py#L272)
**Paramètres :**
outputs (`Owlv2ImageGuidedObjectDetectionOutput`) : Sorties brutes du modèle.
threshold (`float`, *facultatif*, valeur par défaut 0.0) : Seuil de confiance minimal à utiliser pour filtrer les boîtes prédites.
nms_threshold (`float`, *facultatif*, par défaut 0,3) : Seuil d'IoU pour la suppression du non-maximum des boîtes superposées.
target_sizes (`torch.Tensor`, *facultatif*) : Tenseur de forme (batch_size, 2) où chaque entrée correspond à la (hauteur, largeur) de l'image correspondante dans le lot. Si défini, les boîtes englobantes normalisées prédites sont remises à l'échelle des tailles cibles. Si laissé à None, les prédictions ne seront pas dénormalisées.
**Retourne :** `list[Dict]`
Une liste de dictionnaires, chaque dictionnaire contenant les scores, les étiquettes et les boîtes pour une image du lot, telles que prédites par le modèle. Toutes les étiquettes sont définies sur None, car `Owlv2ForObjectDetection.image_guided_detection` effectue une détection d'objets en une seule passe.
Convertit la sortie de [Owlv2ForObjectDetection.image_guided_detection()](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ForObjectDetection.image_guided_detection) dans le format attendu par l'API COCO.
## Owlv2Processor[[transformers.Owlv2Processor]]
#### transformers.Owlv2Processor[[transformers.Owlv2Processor]]
```python
transformers.Owlv2Processor(image_processor, tokenizer, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/processing_owlv2.py#L59)
**Paramètres :**
image_processor (`Owlv2ImageProcessor`) : le processeur d'images est une entrée obligatoire.
tokenizer (`CLIPTokenizer`) : le tokenizer est une entrée obligatoire.
Construit un Owlv2Processor qui encapsule un processeur d’images et un tokenizer en un seul processeur.
[Owlv2Processor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Processor) offre toutes les fonctionnalités de [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor) et de [CLIPTokenizer](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPTokenizer). Consultez [~Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor) et [~CLIPTokenizer](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPTokenizer) pour plus d’informations.
#### __appel__[[transformers.Owlv2Processor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] = None, query_images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/processing_owlv2.py#L71)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *facultatif*) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *facultatif*) : La séquence ou le lot de séquences à encoder. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes (chaîne pré-tokenisée). Si vous transmettez une entrée pré-tokenisée, définissez `is_split_into_words=True` pour éviter toute ambiguïté avec les entrées en lot.
query_images (`ImageInput`, *facultatif*) : Images de requête à utiliser pour la détection d'objets guidée par image. Lorsqu'elles sont fournies, ces images servent de requêtes visuelles pour trouver des objets similaires dans les `images` principales. Les images de requête remplacent les invites de texte, et le modèle effectue un appariement image-à-image au lieu d'un appariement texte-à-image.
return_mm_token_type_ids (`bool`, *kwargs*) : Indique s'il faut retourner les identifiants de type de jeton multimodal indiquant les positions des jetons de substitution multimodaux.
return_text_replacement_offsets (`bool`, *kwargs*) : Indique s'il faut retourner les décalages de caractères pour chaque emplacement multimodal et son remplacement.
return_tensors (`str` ou [TensorType](/docs/transformers/main/fr/internal/file_utils#transformers.TensorType), *facultatif*) : Si défini, renverra des tenseurs d'un framework particulier. Les valeurs acceptables sont : - `'pt'` : Renvoie des objets `torch.Tensor` de PyTorch. - `'np'` : Renvoie des objets `np.ndarray` de NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/fr/main_classes/processors#transformers.ProcessingKwargs), *facultatif*) : Options de traitement supplémentaires pour chaque modalité (texte, images, vidéos, audio). Les paramètres spécifiques au modèle sont répertoriés ci-dessus ; consultez la classe TypedDict pour la liste complète des arguments pris en charge.
**Retourne :** [BatchFeature](/docs/transformers/main/fr/main_classes/feature_extractor#transformers.BatchFeature)
Un [BatchFeature](/docs/transformers/main/fr/main_classes/feature_extractor#transformers.BatchFeature) avec les champs suivants :
- **input_ids** -- Liste des identifiants de jetons à fournir au modèle. Renvoyé lorsque `text` n'est pas `None`.
- **attention_mask** -- Liste d'indices spécifiant les jetons auxquels le modèle doit prêter attention (lorsque `return_attention_mask=True` ou si *"attention_mask"* est présent dans `self.model_input_names` et si `text` n'est pas `None`).
- **pixel_values** -- Valeurs des pixels à fournir à un modèle. Renvoyé lorsque `images` n'est pas `None`.
- **query_pixel_values** -- Valeurs des pixels des images de requête à fournir à un modèle. Renvoyé lorsque `query_images` n'est pas `None`.
#### post_process_grounded_object_detection[[transformers.Owlv2Processor.post_process_grounded_object_detection]]
```python
post_process_grounded_object_detection(outputs: Owlv2ObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None, text_labels: list[list[str]] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/processing_owlv2.py#L162)
**Paramètres :**
outputs (`Owlv2ObjectDetectionOutput`) : Sorties brutes du modèle.
threshold (`float`, *facultatif*, valeur par défaut 0,1) : Seuil de score à appliquer pour conserver les prédictions de détection d'objets.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *facultatif*) : Tenseur de forme `(batch_size, 2)` ou liste de tuples (`tuple[int, int]`) contenant la taille cible `(height, width)` de chaque image du lot. Si non défini, les prédictions ne seront pas redimensionnées.
text_labels (`list[list[str]]`, *facultatif*) : Liste de listes d'étiquettes de texte pour chaque image du lot. Si non défini, « text_labels » dans la sortie sera défini sur `None`.
**Retourne :** `list[Dict]`
Une liste de dictionnaires, chaque dictionnaire contenant les clés suivantes :
- "scores" : les scores de confiance pour chaque boîte prédite sur l'image.
- "labels" : Index des classes prédites par le modèle sur l'image.
- "boxes" : Boîtes englobantes de l'image au format (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
- "text_labels" : les étiquettes de texte pour chaque boîte englobante prédite sur l'image.
Convertit la sortie brute de [Owlv2ForObjectDetection](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ForObjectDetection) en boîtes englobantes finales au format (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
#### post_process_image_guided_detection[[transformers.Owlv2Processor.post_process_image_guided_detection]]
```python
post_process_image_guided_detection(outputs: Owlv2ImageGuidedObjectDetectionOutput, threshold: float = 0.0, nms_threshold: float = 0.3, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/processing_owlv2.py#L211)
**Paramètres :**
outputs (`Owlv2ImageGuidedObjectDetectionOutput`) : Sorties brutes du modèle.
threshold (`float`, *facultatif*, valeur par défaut 0.0) : Seuil de confiance minimal à utiliser pour filtrer les boîtes prédites.
nms_threshold (`float`, *facultatif*, par défaut 0,3) : Seuil d'IoU pour la suppression du non-maximum des boîtes superposées.
target_sizes (`torch.Tensor`, *facultatif*) : Tenseur de forme (batch_size, 2) où chaque entrée correspond à la (hauteur, largeur) de l'image correspondante dans le lot. Si défini, les boîtes englobantes normalisées prédites sont remises à l'échelle des tailles cibles. Si laissé à None, les prédictions ne seront pas dénormalisées.
**Retourne :** `list[Dict]`
Une liste de dictionnaires, chaque dictionnaire contenant les clés suivantes :
- "scores" : les scores de confiance pour chaque boîte prédite sur l'image.
- "boxes" : Boîtes englobantes de l'image au format (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
- "labels" : défini sur `None`.
Convertit la sortie de [Owlv2ForObjectDetection.image_guided_detection()](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ForObjectDetection.image_guided_detection) dans le format attendu par l'API COCO.
## Owlv2Model[[transformers.Owlv2Model]]
#### transformers.Owlv2Model[[transformers.Owlv2Model]]
```python
transformers.Owlv2Model(config: Owlv2Config)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/modeling_owlv2.py#L758)
**Paramètres :**
config ([Owlv2Config](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Config)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle Owlv2 brut, qui produit des états cachés bruts sans aucune tête spécifique au sommet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.Owlv2Model.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = False, return_base_image_embeds: bool | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/modeling_owlv2.py#L852)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs des pixels peuvent être obtenues à l’aide de [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor). Voir [Owlv2ImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([Owlv2Processor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Processor) utilise [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor) pour le traitement des images).
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
return_loss (`bool`, *facultatif*) : Indique s'il faut ou non retourner la perte contrastive.
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
return_base_image_embeds (`bool`, *facultatif*) : Indique s'il faut ou non retourner les embeddings de l'image de base.
**Retourne :** `Owlv2Output` ou `tuple(torch.Tensor)`
Un `Owlv2Output` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([Owlv2Config](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Config)) et les entrées.
La méthode forward du modèle [Owlv2Model](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Model) surcharge la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `return_loss` est `True`) -- Perte contrastive pour la similarité image-texte.
- **logits_per_image** (`torch.Tensor` de forme `(image_batch_size, text_batch_size)`) -- Les scores de produit scalaire normalisé entre `image_embeds` et `text_embeds`. Cela représente les scores de similarité image-texte.
- **logits_per_text** (`torch.Tensor` de forme `(text_batch_size, image_batch_size)`) -- Les scores de produit scalaire normalisé entre `text_embeds` et `image_embeds`. Cela représente les scores de similarité texte-image.
- **text_embeds** (`torch.Tensor` de forme `(batch_size * num_max_text_queries, output_dim`) -- Les embeddings de texte obtenus en appliquant la couche de projection à la sortie agrégée de [Owlv2TextModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2TextModel).
- **image_embeds** (`torch.Tensor` de forme `(batch_size, output_dim`) -- Les embeddings d'image obtenus en appliquant la couche de projection à la sortie agrégée de [Owlv2VisionModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2VisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- La sortie du [Owlv2TextModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2TextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- La sortie du [Owlv2VisionModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2VisionModel).
Exemples :
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Owlv2Model
>>> model = Owlv2Model.from_pretrained("google/owlv2-base-patch16-ensemble")
>>> processor = AutoProcessor.from_pretrained("google/owlv2-base-patch16-ensemble")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(text=[["a photo of a cat", "a photo of a dog"]], images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
```
#### get_text_features[[transformers.Owlv2Model.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/modeling_owlv2.py#L781)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size * num_max_text_queries, sequence_length)`) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([Owlv2Config](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Config)) et les entrées.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> import torch
>>> from transformers import AutoProcessor, Owlv2Model
>>> model = Owlv2Model.from_pretrained("google/owlv2-base-patch16-ensemble")
>>> processor = AutoProcessor.from_pretrained("google/owlv2-base-patch16-ensemble")
>>> inputs = processor(
... text=[["a photo of a cat", "a photo of a dog"], ["photo of a astranaut"]], return_tensors="pt"
... )
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.Owlv2Model.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/modeling_owlv2.py#L818)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor). Voir [Owlv2ImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([Owlv2Processor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Processor) utilise [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor) pour le traitement des images).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([Owlv2Config](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Config)) et les entrées.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> import torch
>>> from transformers.image_utils import load_image
>>> from transformers import AutoProcessor, Owlv2Model
>>> model = Owlv2Model.from_pretrained("google/owlv2-base-patch16-ensemble")
>>> processor = AutoProcessor.from_pretrained("google/owlv2-base-patch16-ensemble")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_features = model.get_image_features(**inputs)
```
## Owlv2TextModel[[transformers.Owlv2TextModel]]
#### transformers.Owlv2TextModel[[transformers.Owlv2TextModel]]
```python
transformers.Owlv2TextModel(config: Owlv2TextConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/modeling_owlv2.py#L610)
#### forward[[transformers.Owlv2TextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/modeling_owlv2.py#L626)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size * num_max_text_queries, sequence_length)`) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([Owlv2Config](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Config)) et les entrées.
La méthode forward du modèle [Owlv2TextModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2TextModel) surcharge la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import AutoProcessor, Owlv2TextModel
>>> model = Owlv2TextModel.from_pretrained("google/owlv2-base-patch16")
>>> processor = AutoProcessor.from_pretrained("google/owlv2-base-patch16")
>>> inputs = processor(
... text=[["a photo of a cat", "a photo of a dog"], ["photo of a astranaut"]], return_tensors="pt"
... )
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## Owlv2VisionModel[[transformers.Owlv2VisionModel]]
#### transformers.Owlv2VisionModel[[transformers.Owlv2VisionModel]]
```python
transformers.Owlv2VisionModel(config: Owlv2VisionConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/modeling_owlv2.py#L707)
#### forward[[transformers.Owlv2VisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/modeling_owlv2.py#L721)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs des pixels peuvent être obtenues à l’aide de [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor). Voir [Owlv2ImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([Owlv2Processor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Processor) utilise [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor) pour le traitement des images).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([Owlv2Config](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Config)) et les entrées.
La méthode forward du modèle [Owlv2VisionModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2VisionModel) surcharge la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, Owlv2VisionModel
>>> model = Owlv2VisionModel.from_pretrained("google/owlv2-base-patch16")
>>> processor = AutoProcessor.from_pretrained("google/owlv2-base-patch16")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled CLS states
```
## Owlv2ForObjectDetection[[transformers.Owlv2ForObjectDetection]]
#### transformers.Owlv2ForObjectDetection[[transformers.Owlv2ForObjectDetection]]
```python
transformers.Owlv2ForObjectDetection(config: Owlv2Config)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/modeling_owlv2.py#L1001)
#### forward[[transformers.Owlv2ForObjectDetection.forward]]
```python
forward(input_ids: Tensor, pixel_values: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/modeling_owlv2.py#L1324)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size * num_max_text_queries, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d’entrée dans le vocabulaire. Les indices peuvent être obtenus à l’aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Voir [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d’entrée ?](../glossary#input-ids).
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor). Voir [Owlv2ImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([Owlv2Processor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Processor) utilise [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor) pour le traitement des images).
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** `Owlv2ObjectDetectionOutput` ou `tuple(torch.Tensor)`
Un `Owlv2ObjectDetectionOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([Owlv2Config](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Config)) et les entrées.
La méthode forward de [Owlv2ForObjectDetection](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ForObjectDetection) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni)) -- Perte totale en tant que combinaison linéaire d'une négation de la log-vraisemblance (entropie croisée) pour la prédiction de classe et d'une perte de boîte englobante. Cette dernière est définie comme une combinaison linéaire de la perte L1 et de la perte d'IoU généralisée insensible à l'échelle.
- **loss_dict** (`Dict`, *facultatif*) -- Un dictionnaire contenant les pertes individuelles. Utile pour la journalisation.
- **logits** (`torch.Tensor` de forme `(batch_size, num_patches, num_queries)`) -- Logits de classification (y compris no-object) pour toutes les requêtes.
- **objectness_logits** (`torch.Tensor` de forme `(batch_size, num_patches, 1)`) -- Les logits d'objectness de tous les patches d'image. OWL-ViT représente les images comme un ensemble de patches d'image où le nombre total de patches est (image_size / patch_size)**2.
- **pred_boxes** (`torch.Tensor` de forme `(batch_size, num_patches, 4)`) -- Coordonnées des boîtes normalisées pour toutes les requêtes, représentées sous la forme (center_x, center_y, width, height). Ces valeurs sont normalisées dans [0, 1], par rapport à la taille de chaque image individuelle du lot (en ignorant tout padding éventuel). Vous pouvez utiliser [post_process_object_detection()](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor.post_process_object_detection) pour récupérer les boîtes englobantes non normalisées.
- **text_embeds** (`torch.Tensor` de forme `(batch_size, num_max_text_queries, output_dim`) -- Les embeddings de texte obtenus en appliquant la couche de projection à la sortie agrégée de [Owlv2TextModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2TextModel).
- **image_embeds** (`torch.Tensor` de forme `(batch_size, patch_size, patch_size, output_dim`) -- Sortie agrégée de [Owlv2VisionModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2VisionModel). OWLv2 représente les images sous forme d'un ensemble de patches d'image et calcule des embeddings d'image pour chaque patch.
- **class_embeds** (`torch.Tensor` de forme `(batch_size, num_patches, hidden_size)`) -- Embeddings de classe de tous les patches d'image. OWLv2 représente les images comme un ensemble de patches d'image où le nombre total de patches est (image_size / patch_size)**2.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- La sortie du [Owlv2TextModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2TextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- La sortie du [Owlv2VisionModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2VisionModel).
Exemples :
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> from transformers import Owlv2Processor, Owlv2ForObjectDetection
>>> processor = Owlv2Processor.from_pretrained("google/owlv2-base-patch16-ensemble")
>>> model = Owlv2ForObjectDetection.from_pretrained("google/owlv2-base-patch16-ensemble")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text_labels = [["a photo of a cat", "a photo of a dog"]]
>>> inputs = processor(text=text_labels, images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # Target image sizes (height, width) to rescale box predictions [batch_size, 2]
>>> target_sizes = torch.tensor([(image.height, image.width)])
>>> # Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> results = processor.post_process_grounded_object_detection(
... outputs=outputs, target_sizes=target_sizes, threshold=0.1, text_labels=text_labels
... )
>>> # Retrieve predictions for the first image for the corresponding text queries
>>> result = results[0]
>>> boxes, scores, text_labels = result["boxes"], result["scores"], result["text_labels"]
>>> for box, score, text_label in zip(boxes, scores, text_labels):
... box = [round(i, 2) for i in box.tolist()]
... print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a photo of a cat with confidence 0.614 at location [341.67, 23.39, 642.32, 371.35]
Detected a photo of a cat with confidence 0.665 at location [6.75, 51.96, 326.62, 473.13]
```
#### image_guided_detection[[transformers.Owlv2ForObjectDetection.image_guided_detection]]
```python
image_guided_detection(pixel_values: Tensor, query_pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/owlv2/modeling_owlv2.py#L1235)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor). Voir [Owlv2ImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([Owlv2Processor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Processor) utilise [Owlv2ImageProcessor](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor) pour le traitement des images).
query_pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, height, width)`) : Valeurs des pixels de l’image ou des images de requête à détecter. Transmettez une image de requête par image cible.
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** `Owlv2ImageGuidedObjectDetectionOutput` ou `tuple(torch.Tensor)`
Un `Owlv2ImageGuidedObjectDetectionOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([Owlv2Config](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2Config)) et les entrées.
- **logits** (`torch.Tensor` de forme `(batch_size, num_patches, num_queries)`) -- Logits de classification (y compris no-object) pour toutes les requêtes.
- **image_embeds** (`torch.Tensor` de forme `(batch_size, patch_size, patch_size, output_dim`) -- Sortie agrégée de [Owlv2VisionModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2VisionModel). OWLv2 représente les images sous forme d'un ensemble de patches d'image et calcule des embeddings d'image pour chaque patch.
- **query_image_embeds** (`torch.Tensor` de forme `(batch_size, patch_size, patch_size, output_dim`) -- Sortie agrégée de [Owlv2VisionModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2VisionModel). OWLv2 représente les images sous forme d'un ensemble de patches d'image et calcule des embeddings d'image pour chaque patch.
- **target_pred_boxes** (`torch.Tensor` de forme `(batch_size, num_patches, 4)`) -- Coordonnées des boîtes normalisées pour toutes les requêtes, représentées sous la forme (center_x, center_y, width, height). Ces valeurs sont normalisées dans [0, 1], par rapport à la taille de chaque image cible individuelle du lot (en ignorant tout padding éventuel). Vous pouvez utiliser [post_process_object_detection()](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor.post_process_object_detection) pour récupérer les boîtes englobantes non normalisées.
- **query_pred_boxes** (`torch.Tensor` de forme `(batch_size, num_patches, 4)`) -- Coordonnées des boîtes normalisées pour toutes les requêtes, représentées sous la forme (center_x, center_y, width, height). Ces valeurs sont normalisées dans [0, 1], par rapport à la taille de chaque image de requête individuelle du lot (en ignorant tout padding éventuel). Vous pouvez utiliser [post_process_object_detection()](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2ImageProcessor.post_process_object_detection) pour récupérer les boîtes englobantes non normalisées.
- **class_embeds** (`torch.Tensor` de forme `(batch_size, num_patches, hidden_size)`) -- Embeddings de classe de tous les patches d'image. OWLv2 représente les images comme un ensemble de patches d'image où le nombre total de patches est (image_size / patch_size)**2.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- La sortie du [Owlv2TextModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2TextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- La sortie du [Owlv2VisionModel](/docs/transformers/main/fr/model_doc/owlv2#transformers.Owlv2VisionModel).
Exemples :
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> from transformers import AutoProcessor, Owlv2ForObjectDetection
>>> processor = AutoProcessor.from_pretrained("google/owlv2-base-patch16-ensemble")
>>> model = Owlv2ForObjectDetection.from_pretrained("google/owlv2-base-patch16-ensemble")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> query_url = "http://images.cocodataset.org/val2017/000000001675.jpg"
>>> with httpx.stream("GET", query_url) as response:
... query_image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, query_images=query_image, return_tensors="pt")
>>> # forward pass
>>> with torch.no_grad():
... outputs = model.image_guided_detection(**inputs)
>>> target_sizes = torch.Tensor([image.size[::-1]])
>>> # Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> results = processor.post_process_image_guided_detection(
... outputs=outputs, threshold=0.9, nms_threshold=0.3, target_sizes=target_sizes
... )
>>> i = 0 # Retrieve predictions for the first image
>>> boxes, scores = results[i]["boxes"], results[i]["scores"]
>>> for box, score in zip(boxes, scores):
... box = [round(i, 2) for i in box.tolist()]
... print(f"Detected similar object with confidence {round(score.item(), 3)} at location {box}")
Detected similar object with confidence 1.0 at location [341.76, 22.77, 640.65, 370.25]
Detected similar object with confidence 1.0 at location [6.59, 51.43, 329.05, 476.77]
```